2x RTX 5060 Ti vs GB10: De ce 32 GB de VRAM pierd în fața a 128 GB de memorie unificată
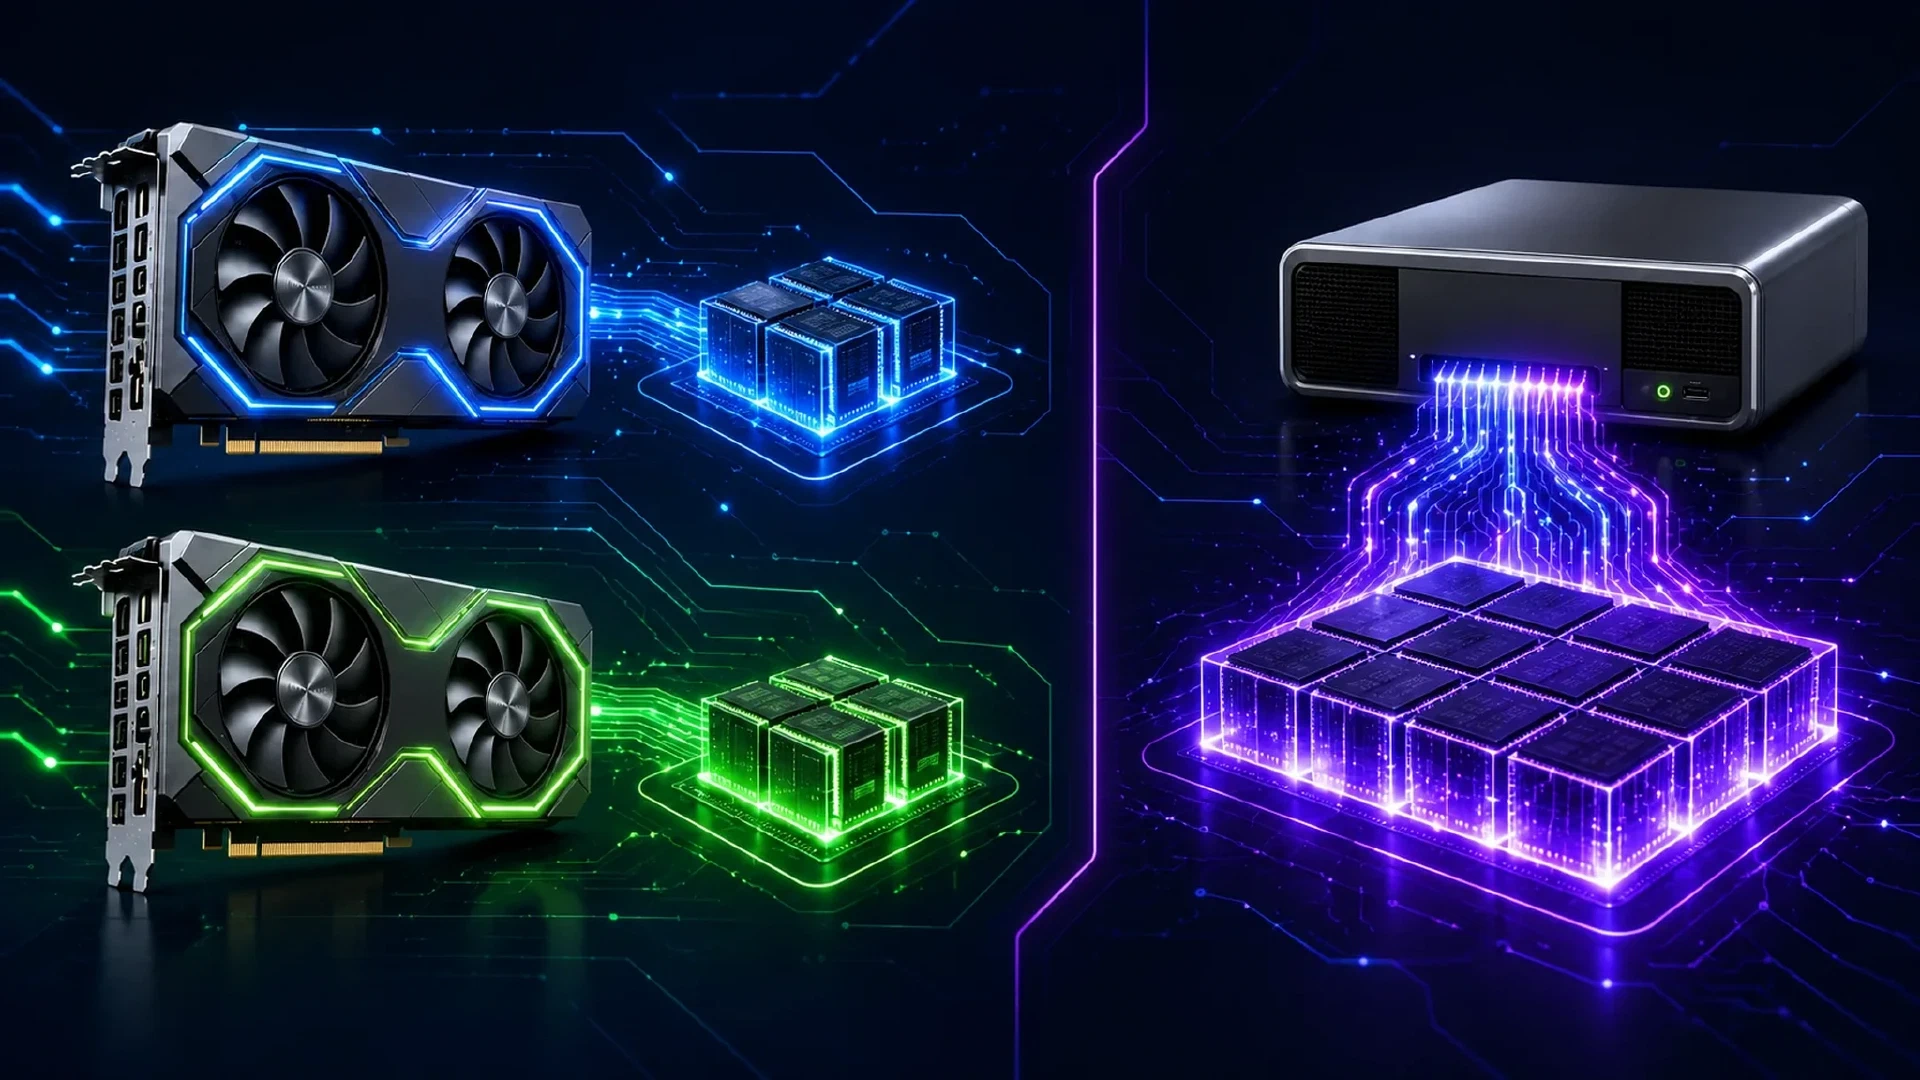
Table of Contents
Două plăci RTX 5060 Ti de 16 GB arată atractiv pe o listă de componente. Ele oferă 32 GB de VRAM agregată și procesare rapidă a prompturilor la context scurt. Comparația se schimbă când rulezi un model 27B cu un context lung.
Sistemul NVIDIA GB10 folosește 128 GB de memorie unificată coerentă. NVIDIA listează platforma GB10 cu 128 GB de memorie unificată LPDDR5x și un TDP al cipului de 140 W. RTX 5060 Ti folosește 16 GB de GDDR7 pe placă, interfață de memorie de 128 de biți și o putere grafică totală de 180 W. Specificațiile NVIDIA RTX 5060 Ti și specificațiile NVIDIA GB10 fac diferența hardware clară.
Ideea este simplă. Două plăci de 16 GB nu creează un singur pool rapid de memorie de 32 GB. Ele creează două pool-uri separate de 16 GB conectate prin sistemul gazdă. Pentru inferența modelelor mari, capacitatea lipsă și transferul datelor între dispozitive contează mai mult decât numărul plăcilor.
Comparația memoriei
| Sistem | Memorie | Model de memorie | Putere raportată |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB agregat | Două pool-uri separate de memorie GPU | 360 W GPU total |
| Sistem GB10 | 128 GB | Memorie de sistem unificată coerentă | TDP GB10 de 140 W |
GB10 nu câștigă deoarece 128 GB de LPDDR5x egalează lățimea de bandă a unui GPU discret de top. Avantajul vine din capacitate și amplasare. CPU-ul și GPU-ul partajează același spațiu de adrese, astfel încât modelul, buffer-ele runtime, activările și datele de context nu trebuie să încapă în două dispozitive izolate de 16 GB.
Sistemul cu două plăci are o problemă mai dificilă de amplasare. Modelul trebuie să încapă pe ambele plăci. Runtime-ul de inferență trebuie să mute date între ele. Traficul PCIe adaugă latență și consumă lățime de bandă. RTX 5060 Ti nu acceptă nici NVLink, conform specificațiilor NVIDIA.
Rezultatul benchmarkului
Rezultatele următoare provin din raportul de benchmark AI furnizat. Raportul compară un sistem dual-GPU fără nume, denumit 5060ti-x2, cu un sistem GB10. Testul acoperă Qwen și GPT-OSS la mai multe dimensiuni de context.
Modelele au venit direct din Ollama. Testul a folosit tagurile implicite literale qwen3.8:27b și gpt-oss:latest, fără Modelfile personalizat sau cuantizare alternativă. Sistemul 5060ti-x2 a folosit PCIe Gen4 x16 și cele mai recente drivere NVIDIA pentru Linux disponibile la rularea benchmarkului.
Procesarea promptului și generarea Qwen
| Context | Prompt 5060ti-x2 tok/s | Generare 5060ti-x2 tok/s | Prompt GB10 tok/s | Generare GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
La 4K, sistemul cu două plăci generează de aproximativ două ori mai rapid decât GB10. La 64K, avantajul scade la aproximativ 1,5 ori. La 128K, sistemele ajung la viteze de generare aproximativ egale.
La 256K, comparația nu mai arată ca o victorie pentru configurația cu două plăci. Cererea 5060ti-x2 a ajuns la numai 171.359 de tokeni reali de prompt. Generarea a scăzut la 1,2 tokeni pe secundă. GB10 a finalizat testul complet de 256K la 25,8 tokeni pe secundă.
În rezultatul testat la 256K, GB10 a generat de aproximativ 21,5 ori mai rapid. Mai important, GB10 a finalizat contextul solicitat. Sistemul cu două plăci nu a livrat aceeași sarcină.
De ce VRAM agregată induce în eroare
1. Modelul nu vede o singură placă de 32 GB
Două GPU-uri nu își unesc memoria într-un singur spațiu local de adrese. Un runtime model-parallel împarte straturile sau tensorii între dispozitive. Fiecare dispozitiv are nevoie de spațiu pentru greutățile alocate, buffer-ele temporare și o parte din starea contextului.
Capacitatea utilizabilă este astfel mai mică decât sugerează suma simplă. Overheadul exact depinde de formatul modelului, cuantizare, backendul de inferență, împărțirea tensorilor și lungimea contextului.
2. Memoria contextului crește în timpul generării
Greutățile modelului sunt doar o parte din bugetul de memorie. Key-value cache, sau KV cache, stochează datele de atenție pentru tokenii anteriori. Contextele mai lungi cer mai multă memorie cache. Un test de 4K nu prezice o implementare de 128K sau 256K.
Rezultatele furnizate arată clar această limită. Sistemul cu două plăci păstrează un avantaj puternic la procesarea promptului, apoi pierde performanță la generare pe măsură ce contextul crește. GB10 rămâne aproape de 26 până la 29 de tokeni de generare pe secundă de la 4K la 256K.
3. Transferurile PCIe adaugă un cost
Când runtime-ul mută activări sau tensori între GPU-uri, transferul trece prin interconectarea gazdei. Acest lucru creează puncte de sincronizare și adaugă latență fiecărui pas. Penalizarea crește când sarcina traversează în mod repetat limita dintre dispozitive.
Acest lucru nu face un sistem dual-GPU inutil. Amplasarea memoriei face parte din rezultatul de performanță. Un benchmark care raportează doar procesarea promptului la 4K ignoră acest cost.
4. Eficiența energetică este un avantaj la nivel de sistem
În comparație, GB10 consumă mai puțină energie și oferă mai multă capacitate de memorie pentru sarcina testată cu context lung. Două plăci RTX 5060 Ti au o putere GPU combinată de 360 W înainte de restul sistemului. NVIDIA listează TDP-ul GB10 la 140 W.
GB10 schimbă viteza maximă la context scurt pentru capacitate, finalizare și putere GPU mai mică. Aceste compromisuri contează pentru inferența Qwen cu context lung.
Sistemul 5060ti-x2 costă mult mai puțin
Comparația performanței nu șterge diferența de preț. O stație de lucru completă cu două RTX 5060 Ti de 16 GB era listată la $3,479 pe 10 octombrie 2026. Configurația include Intel Ultra 7 265K, placă de bază Z890, 32 GB DDR5, stocare de 1 TB, sursă de 1.000 W și ambele GPU-uri. Vezi listarea completă a stației dual-GPU .
Marketplace-ul NVIDIA din SUA listează DGX Spark de 128 GB la $6,950. Listarea include 128 GB de memorie unificată coerentă și 4 TB de stocare NVMe, dar arată sistemul ca indisponibil. Verifică listarea actuală NVIDIA DGX Spark .
AMD Ryzen AI Halo Developer Platform oferă un alt punct de comparație. Acest sistem Strix Halo este listat la $3,999.99 la Micro Center cu 128 GB de memorie unificată LPDDR5x și 2 TB de stocare. Strix Halo intră adesea în aceeași clasă practică de AI local ca sistemele GB10, deși testele independente măsoară frecvent GB10 înainte la throughput și maturitatea software-ului. Verifică listarea Linux actuală de la Micro Center și citește recenzia Strix Halo versus GB10 .
| Sistem complet | Preț listat la 10 octombrie 2026 | Diferență de preț |
|---|---|---|
| Stație 5060ti-x2 | $3,479 | Bază |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 în plus |
| GB10 DGX Spark de 128 GB | $6,950 | $3,471 în plus |
GB10 oferă un pool mai mare de memorie unificată, consum mai mic și o arhitectură mai bună pentru context lung. Sistemul AMD oferă aceeași clasă de memorie de 128 GB pentru aproximativ 4.000 USD. Stația 5060ti-x2 rămâne la aproximativ 50% din prețul listat al GB10, înainte de taxe și livrare. Cumpărătorii care au nevoie de memorie unificată, dar nu de stackul software NVIDIA, au o alternativă mai ieftină în Strix Halo.
Acestea sunt prețuri listate de furnizori diferiți, nu un coș de retail controlat. Comparația lasă și sistemul 5060ti-x2 cu mai puțină memorie de sistem și stocare. Diferența de preț contează deoarece ambele listări descriu computere complete și utilizabile, nu doar prețuri pentru GPU-uri. Listările actuale pentru plăci RTX 5060 Ti de 16 GB sunt aproape de $789 până la $830 fiecare, mult peste MSRP-ul de lansare de $429. Avantajul de preț al configurației cu două plăci persistă chiar și în timpul creșterii actuale a prețurilor GPU. Verificarea prețurilor actuale pentru RTX 5060 Ti .
Rezultatul GPT-OSS necesită un tratament separat
Același raport arată rezultate puternice de generare 5060ti-x2 pentru GPT-OSS de la 4K la 256K. GB10 finalizează testele de la 4K la 128K, dar testul GPT-OSS de 256K este marcat unsupported.
Nu folosi tabelul GPT-OSS pentru a declara un câștigător universal. Testele nu acoperă aceeași gamă la 256K. Rezultatul Qwen oferă comparația mai clară pentru context lung deoarece ambele sisteme raportează un rezultat 256K, chiar dacă rularea 5060ti-x2 a ajuns la numai 171.359 de tokeni reali de prompt.
Ce înseamnă pentru un build Qwen 3 27B
O configurație cu două plăci de 16 GB poate rula un model cuantizat 27B cu un context mai mic. Benchmarkul nu infirmă acest caz de utilizare. Datele infirmă afirmația că 32 GB de VRAM agregată oferă aceeași rezervă practică precum un sistem cu 128 GB de memorie unificată.
Faptul că un model încape pe o placă dovedește doar capacitatea pentru greutăți. Necesarul real de memorie este format din greutățile modelului, contextul activ, KV cache, buffer-ele runtime și rezerva sistemului de operare. Contextul trebuie să încapă alături de model. Un model care se încarcă, dar nu are loc pentru conversația de lucru, nu este o configurație utilizabilă cu context lung.
Acest lucru corespunde recomandărilor de dimensionare din Este suficientă VRAM de 16 GB pentru lucrul serios cu LLM local? , care tratează greutățile, contextul și alocările runtime ca un singur buget. Ghidul de 32 GB VRAM pentru Qwen 27B ajunge la aceeași concluzie pentru buildurile cu două plăci. Capacitatea agregată nu este egală cu rezerva utilizabilă.
Pentru o implementare Qwen 3 27B, pune patru întrebări înainte de a cumpăra hardware:
- Încape cuantizarea cerută împreună cu buffer-ele runtime? Greutățile modelului singure nu definesc necesarul de memorie.
- Încape contextul fără presiune severă asupra KV cache? Prompturile lungi schimbă rezultatul.
- Folosește runtime-ul o împărțire rapidă între dispozitive? Transferurile PCIe și amplasarea tensorilor afectează fiecare token generat.
- Sistemul finalizează contextul țintă? Un rezultat rapid la 4K nu compensează o sarcină 256K eșuată.
Testul furnizat răspunde la ultima întrebare pentru sistemul cu două plăci. Rularea a ajuns la 171.359 de tokeni în timpul cererii Qwen 256K și a generat la 1,2 tokeni pe secundă. GB10 a finalizat 256K la 25,8 tokeni pe secundă.
Pentru această sarcină cu context lung, memoria unificată este arhitectura mai bună când alternativa se bazează pe PCIe pentru a acoperi setul de lucru al modelului. PCIe rămâne o soluție de capacitate. PCIe nu creează același pool de memorie, aceeași latență sau aceeași cale de transfer. Ghidul de context GPU pentru AI local explică de ce greutățile modelului, KV cache, rezultatul instrumentelor și buffer-ele runtime trebuie dimensionate împreună. Benchmarkul GPU Ollama Qwen3.8 27B arată și de ce rezultatele cu context lung necesită atenție separată față de cifrele de decodare la context scurt.
Verdict
Două plăci RTX 5060 Ti de 16 GB sunt un înlocuitor slab pentru GB10 când obiectivul este inferența 27B cu context lung. Ele oferă throughput mai mare la prompturi cu dimensiuni mici de context. Folosesc și mai multă putere GPU și expun runtime-ul unui layout de memorie împărțit.
GB10 este mai lent la procesarea promptului în rezultatele furnizate. Sistemul este mai eficient energetic, oferă de patru ori memoria agregată și finalizează testul Qwen complet de 256K cu o viteză de generare utilizabilă.
Dacă rulezi prompturi scurte și apreciezi ingestia promptului, 5060ti-x2 are un caz restrâns. Pentru un model 27B, pool-ul mai mare de memorie unificată este alegerea mai bună deoarece modelul și contextul partajează un set de lucru coerent. Memoria unificată rămâne preferabilă când transferurile PCIe intră în calea de inferență.
Benchmarkul nu arată că două plăci RTX 5060 Ti nu pornesc niciodată Qwen 3 27B. Datele arată de ce pornirea modelului este diferită de rularea bună a sarcinii.
Limitele benchmarkului
Raportul furnizat identifică tagurile literale Ollama, dar nu înregistrează digesturile manifesturilor rezolvate, reviziile modelelor, CPU-ul, măsurătorile de putere sau configurația de răcire. Raportul identifică și PCIe Gen4 x16 pentru sistemul 5060ti-x2 și driverele NVIDIA actuale pentru Linux în momentul testului. Tratează cifrele ca o comparație observată între sisteme, nu ca un clasament universal al fiecărei perechi RTX 5060 Ti și fiecărei implementări GB10.
Specificațiile hardware de mai sus provin de la NVIDIA. Cifrele de performanță provin din datele benchmarkului furnizate pentru acest articol.
Referințe
- Biblioteca de modele Ollama Qwen3.8
- Tagurile de modele Ollama GPT-OSS
- Este suficientă VRAM de 16 GB pentru lucrul serios cu LLM local?
- 32 GB VRAM pentru Qwen 27B
- Ghidul de context GPU pentru AI local
- Benchmarkuri GPU Qwen3.8 27B pe Vast.ai
- Listarea stației de lucru cu două RTX 5060 Ti de 16 GB
- Listarea NVIDIA DGX Spark pe marketplace-ul SUA
- Listarea Linux AMD Ryzen AI Halo de 128 GB
- Recenzia Tom’s Hardware despre Strix Halo și GB10
- Verificarea prețurilor actuale pentru RTX 5060 Ti
Related Posts