Certificările de securitate cibernetică AI: rămân în urmă

Table of Contents
Am dat examenele. Le-am trecut. Am primit certificate și am rămas cu un nivel de dezamăgire pe care vreau să-l descriu exact.
Nu critic persoanele care au creat aceste programe. Ele lucrează cu materiale incomplete. Securitatea AI este o disciplină tânără. Cercetarea atacurilor avansează mai repede decât instrumentele defensive. Cadrele de guvernanță au apărut înaintea îndrumărilor de inginerie.
Problema este diferența dintre ceea ce predau certificările și ceea ce trebuie să știi pentru a securiza efectiv sistemele AI în producție.
Trei niveluri care sunt confundate frecvent
Înainte de a explica ce lipsește, este util să separăm lucrurile care există deja.
Primul nivel este guvernanța. Documente precum NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 și EU AI Act acționează la nivel organizațional și de proces. Ele descriu cum se gestionează riscul AI, cum se structurează supravegherea și cum se documentează responsabilitatea. Se concentrează intenționat pe guvernanță, nu pe prescrierea controalelor tehnice. Acesta este scopul lor.
Al doilea nivel este taxonomia amenințărilor. MITRE ATLAS documentează tacticile adversarilor împotriva sistemelor AI în același format ca ATT&CK. OWASP Top 10 for Large Language Model Applications enumeră categoriile de atac cele mai relevante pentru LLM-urile implementate. Aceste documente numesc atacurile și descriu cum funcționează. Nu prescriu măsuri de apărare.
Al treilea nivel este îndrumarea tehnică. Include Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) și documentația de securitate a furnizorilor precum Anthropic, OpenAI și Meta. Acestea oferă îndrumări de inginerie pentru implementare sigură, practici de evaluare și controale la runtime.
Majoritatea certificărilor de guvernanță AI acoperă în detaliu primul nivel. Îl menționează pe al doilea la nivel general și rareori abordează al treilea.
Ce acoperă certificările
Certificările disponibile în prezent pentru guvernanță și securitate AI, inclusiv IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, certificările ISO 42001 și CompTIA AI+, acoperă un set similar de subiecte.
Înveți NIST AI RMF și cum să mapezi cele patru funcții ale sale, Govern, Map, Measure și Manage, la implementarea AI a organizației. Înveți clasificările nivelurilor de risc din EU AI Act și cum arată evaluarea conformității pentru sistemele cu risc ridicat. Înveți despre prejudecată, echitate, transparență și responsabilitate ca principii de guvernanță. Înveți să redactezi politici de guvernanță AI și să efectuezi evaluări de impact.
Acestea sunt competențe reale. Organizațiile au nevoie de oameni care înțeleg cadrele de guvernanță și citesc NIST AI RMF ca să știe ce le cere să construiască.
Certificările nu predau cu aceeași profunzime:
- Cum compromit atacatorii sistemele AI în producție
- Cum arată în practică apărarea în profunzime împotriva prompt injection și de ce niciun control singular nu o elimină
- Cum se verifică integritatea modelelor înainte de implementare
- Ce presupune red teaming-ul specific AI și cum se stabilește domeniul acestuia
- Cum se evaluează comportamentul modelului față de intrări adversariale înainte de lansare
- Cum arată observabilitatea AI în timpul inferenței
- Prin ce diferă răspunsul la incidente AI de procedurile IR standard
- Ce presupune securizarea agenților AI cu acces la instrumente și integrări externe
NIST AI RMF se ocupă de guvernanță, nu de inginerie
NIST AI RMF este un document bine construit. NIST l-a proiectat ca fiind neutru din punct de vedere tehnologic, independent de sector și aplicabil diferitelor abordări de dezvoltare AI. Astfel, cadrul poate fi folosit pe scară largă.
Înseamnă și că nu prescrie controale tehnice pentru anumite clase de atac. Dacă organizația adoptă complet AI RMF și își mapează toate funcțiile la implementarea AI, va avea procese de risc documentate. Nu va avea neapărat o apărare împotriva prompt injection pentru modelul de limbaj implementat.
NIST recunoaște acest lucru. NIST AI 600-1, Generative AI Profile, publicat în 2024, extinde AI RMF pentru AI generativă și modele lingvistice mari. Acoperă riscuri precum prompt injection, otrăvirea datelor și pericolele informaționale cu un nivel de detaliu pe care AI RMF de bază nu îl atinge. Dacă certificarea ta a acoperit AI RMF de bază fără AI 600-1, ai ratat documentul cel mai relevant pentru sistemele implementate în prezent.
ISO 42001 și comparația cu sistemele de management
ISO 42001:2023 este un standard pentru sistemele de management AI. Oferă o structură pentru guvernarea dezvoltării și implementării AI la nivel organizațional. Specialiștii în securitate vor recunoaște asemănarea cu ISO 27001, standardul de securitate a informațiilor.
ISO 27001 este adoptat pe scară largă. Organizațiile certificate tot suferă breșe. Certificarea documentează existența unui sistem de management, respectarea unui proces definit și efectuarea revizuirilor. Nu certifică faptul că sistemele guvernate prin acest proces rezistă atacurilor îndreptate împotriva lor.
ISO 42001 oferă disciplină organizațională. Certificarea le arată părților interesate că procesele AI sunt documentate, revizuite și guvernate. Nu demonstrează că modelele implementate generează rezultate consecvente în condiții adversariale, că agenții respectă limitele de încredere definite sau că modelele ajustate au fost construite din date de antrenare verificate.
Aceasta este aceeași diferență ca în cazul ISO 27001. Am învățat să o acceptăm în securitatea cibernetică tradițională. Nu ar trebui să pretindem că certificările de guvernanță AI o elimină, când au aceeași limitare structurală.
EU AI Act cere rezultate, dar nu specifică ingineria
EU AI Act clasifică sistemele AI după nivelul de risc: inacceptabil (interzis), ridicat (necesită evaluarea conformității), limitat (obligații de transparență) și minim (fără cerințe specifice).
Sistemele cu risc ridicat, inclusiv cele folosite în infrastructura critică, identificarea biometrică, selecția candidaților, educație și aplicarea legii, trebuie să îndeplinească cerințe privind documentația tehnică, supravegherea umană și robustețea. Actul cere explicit ca sistemele AI cu risc ridicat să reziste încercărilor de modificare a comportamentului prin manipulare adversarială.
Această cerință apare în text. Actul specifică intenționat rezultatele, nu controalele tehnice. Încă nu există soluții acceptate de comun acord pentru a demonstra robustețea adversarială în toate contextele de implementare, pentru fiecare tip de sistem și caz de utilizare.
Certificările bazate pe EU AI Act te pregătesc să clasifici sistemele AI, să redactezi documentație tehnică și să structurezi protocoale de supraveghere. Te pregătesc pentru audit. Ingineria necesară pentru un sistem care respectă cerințele de robustețe ține de o disciplină diferită de cea acoperită în prezent de certificări.
Ce atacă efectiv sistemele AI
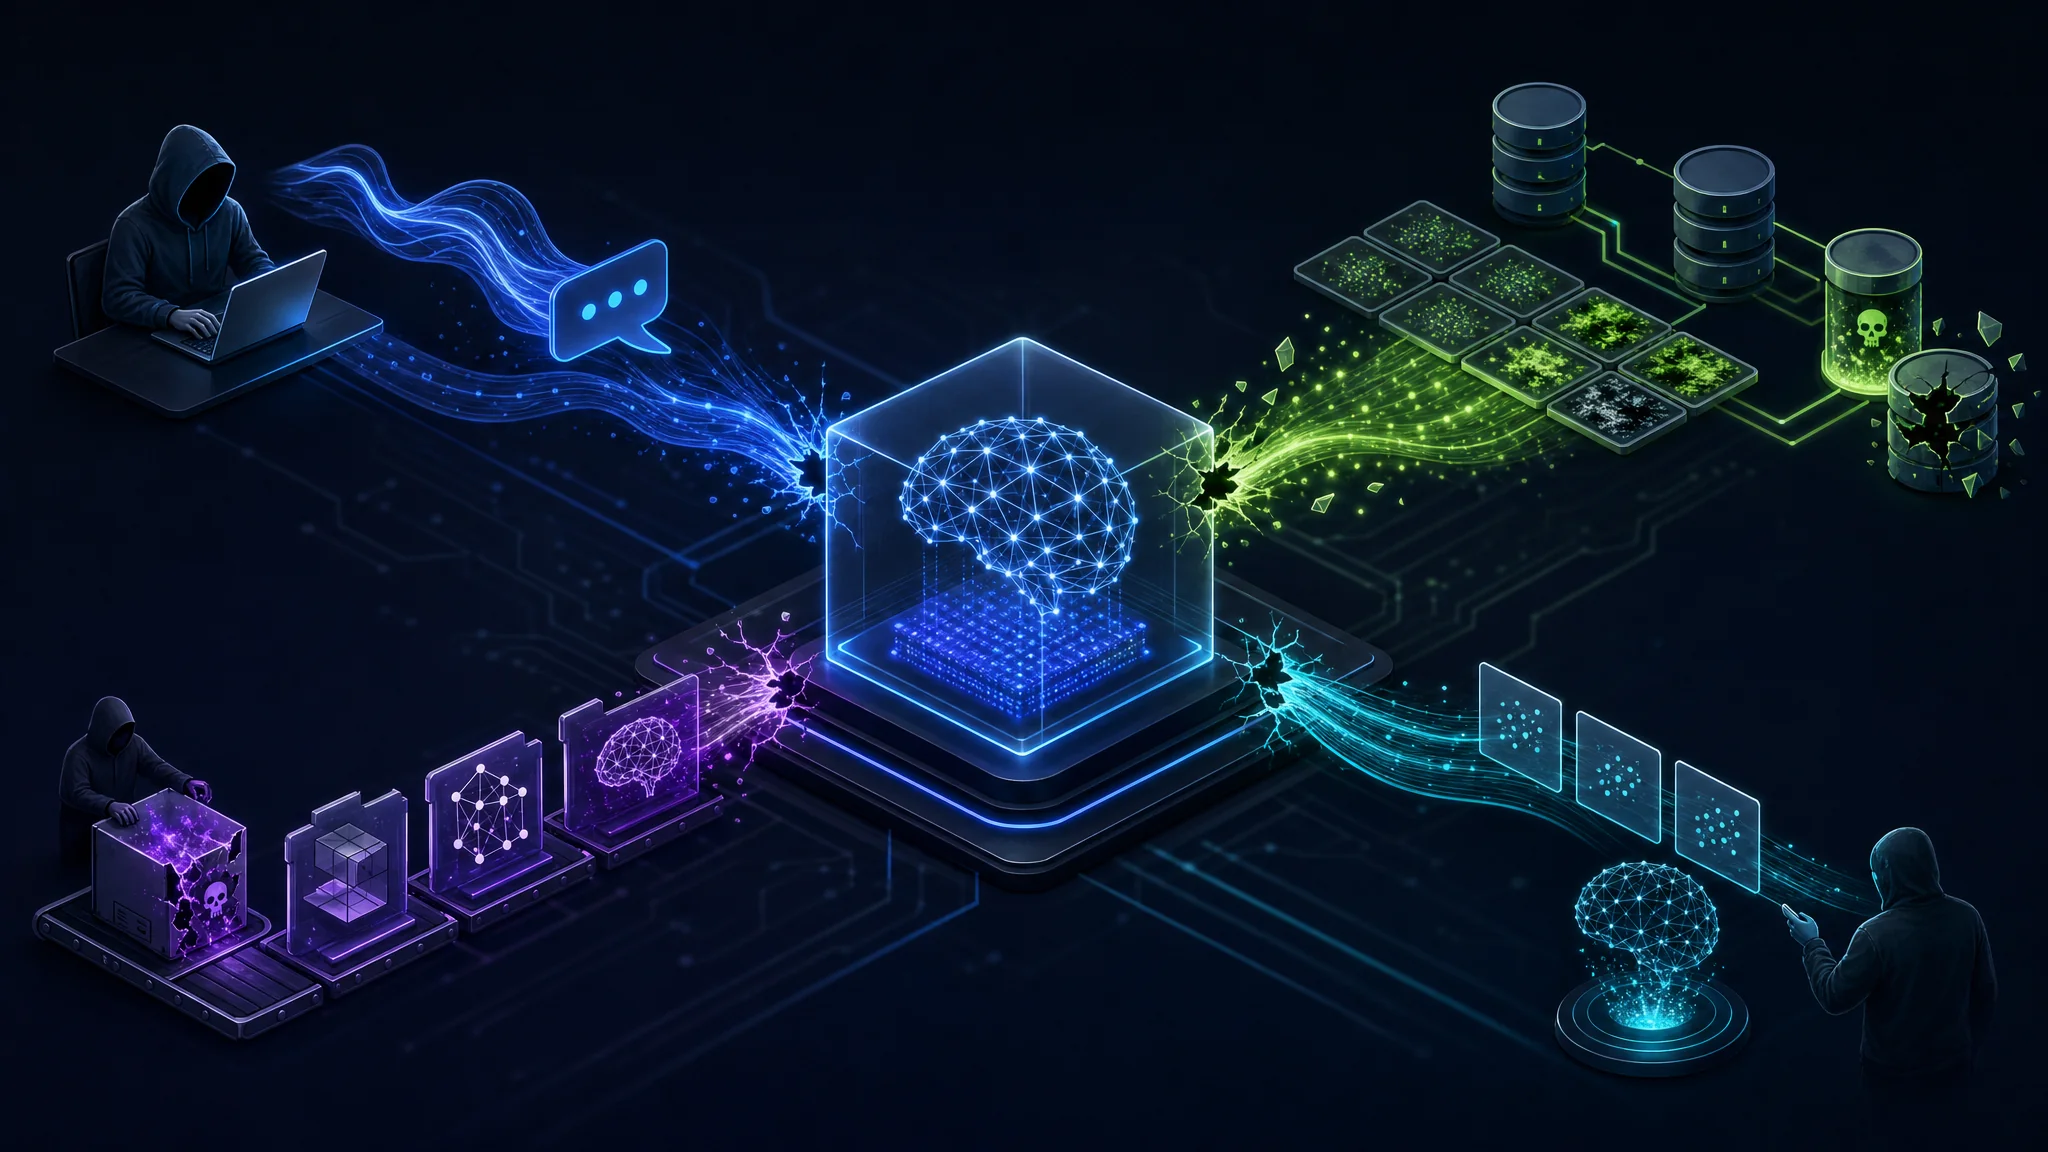
MITRE ATLAS și OWASP LLM Top 10 documentează peisajul operațional al amenințărilor. Aceste resurse enumeră atacurile la un nivel util de detaliu. Cadrele de guvernanță descriu amenințările mai abstract. Informațiile următoare provin din aceste surse specializate în securitate.
Prompt injection funcționează prin trimiterea unei intrări către un model lingvistic, care suprascrie sau manipulează instrucțiunile sistemului. Injecția directă vizează intrarea modelului. Injecția indirectă ascunde instrucțiuni malițioase în conținutul pe care modelul îl recuperează, procesează sau rezumă. Pipeline-ul RAG citește un document controlat de atacator și execută instrucțiunile ascunse în el. Agentul de navigare vizitează o pagină controlată de atacator și îi urmează instrucțiunile. Botul de asistență pentru clienți rezumă un articol de suport care îi cere să ignore regulile de siguranță.
În 2026 nu există o măsură de protecție universal eficientă împotriva prompt injection. Apărarea în profunzime reduce riscul prin filtrarea intrărilor, validarea ieșirilor, limitarea privilegiilor instrumentelor, medii de execuție izolate și aprobarea umană pentru acțiuni cu impact. Niciuna dintre aceste măsuri nu elimină clasa de atac. NIST, OWASP, Anthropic, OpenAI, Google și Microsoft recomandă controale în straturi, nu soluții singulare.
Otrăvirea datelor de antrenare introduce exemple malițioase în date pentru a degrada comportamentul modelului, a adăuga backdoor-uri sau a implanta comportamente declanșate de anumite intrări. Semnele unei otrăviri reușite lipsesc adesea până când modelul întâlnește intrări declanșatoare specifice. Dacă organizația ajustează modelele pe baza conținutului creat de utilizatori, a documentelor recuperate sau a seturilor de date de la terți fără să le verifice proveniența, se expune acestui risc.
Compromiterea lanțului de aprovizionare al modelelor este un risc pe care majoritatea organizațiilor îl tratează ca pe o grijă secundară. Depozitele de modele distribuie frecvent cod executabil împreună cu ponderile modelelor. Formate de serializare nesigure precum pickle au creat repetat riscuri pentru lanțul de aprovizionare. Pachetele asociate descărcărilor de modele pot instala dependențe vulnerabile. Multe organizații par să verifice modelele din depozite publice mult mai puțin riguros decât dependențele software. Suprafața de atac este comparabilă cu npm, dar cultura de securitate din acest domeniu este mult mai puțin matură.
Extragerea modelelor le permite atacatorilor să reconstruiască modele similare funcțional prin interogări repetate de inferență către API. Aceasta înseamnă atât pierderea proprietății intelectuale, cât și posibilitatea de a studia modelul offline pentru a pregăti atacuri mai țintite.
Inferența apartenenței permite atacatorilor să determine, cu niveluri diferite de încredere, dacă anumite înregistrări de date au fost incluse în setul de antrenare. Rezultatul depinde de arhitectura modelului și de metoda de antrenare. Creează riscuri de confidențialitate pentru organizațiile care au antrenat modele pe informații personale.
Intrările adversariale manipulează ieșirile modelului prin perturbări atent construite. Tehnica este cel mai bine studiată în clasificarea imaginilor, dar se aplică și textului, sunetului și sistemelor multimodale. Dacă AI ia decizii despre detectarea fraudei, bonitate, imagistică medicală sau acces fizic, robustețea adversarială este o proprietate de securitate care trebuie testată, nu doar documentată.
Scurgerile de date prin sistemele AI necesită atenție directă. Pipeline-urile RAG expun documente din baza de cunoștințe, uneori utilizatorilor care nu ar trebui să aibă acces. Scurgerea promptului dezvăluie detalii operaționale pe care doreai să le păstrezi confidențiale. Implementările AI multi-tenant necesită izolare, pe care inginerii tradiționali de securitate a aplicațiilor o pot subestima. Aceste riscuri apar frecvent în sistemele implementate.
Agenții AI schimbă complet suprafața de atac
Majoritatea certificărilor de securitate AI au fost scrise când sistemele AI însemnau în principal chatboți și clasificatoare. În 2026, AI în mediul enterprise înseamnă tot mai des agenți.
Agenții se deosebesc de chatboți printr-un aspect operațional important: acționează. Un agent cu acces la instrumente pentru e-mail, baze de date interne, sisteme de fișiere, browser și execuția codului nu este un chatbot cu funcții suplimentare. Este un proces autonom, cu acces semnificativ la sisteme reale, care funcționează pe baza ieșirilor unui model lingvistic.
OWASP menține acum un Agentic AI Top 10 separat, deoarece modelul de amenințări pentru agenți diferă suficient de aplicațiile de chat LLM încât să necesite documentație separată.
În contextul unui agent, prompt injection nu produce un răspuns text nedorit, ci o acțiune nedorită. O instrucțiune injectată indirect într-un document recuperat îi poate cere agentului să șteargă fișiere, să exfiltreze date sau să trimită e-mailuri. Consecința nu este un răspuns nepotrivit, ci o acțiune neautorizată împotriva sistemelor accesibile agentului.
Suprafața de atac a agenților include:
- Limitele apelurilor de instrumente: dacă agentul este restricționat la setul minim de instrumente adecvat fiecărei sarcini
- Domeniul acreditărilor: dacă acreditările agentului sunt limitate la ce necesită fiecare sarcină
- Reversibilitatea acțiunilor: dacă acțiunile importante necesită aprobarea unei persoane înainte de execuție
- Filtrarea ieșirilor: dacă ieșirile agentului sunt validate înainte de a declanșa acțiuni ulterioare
- Izolarea: dacă mediul de execuție al agentului împiedică accesul neintenționat la sistemele conectate
Majoritatea certificărilor de guvernanță AI nu acoperă proiectarea securității agenților cu acest nivel de detaliu.
Model Context Protocol creează o nouă suprafață de atac enterprise
Model Context Protocol (MCP) a devenit un standard răspândit pentru conectarea agenților AI la instrumente, surse de date și servicii externe. Serverele MCP expun capabilități pe care agenții le descoperă și le folosesc. Integrarea este rapidă și flexibilă, dar implicațiile pentru securitate nu primesc întotdeauna aceeași atenție.
Riscurile specifice MCP includ:
- Servere MCP malițioase care își prezintă în mod fals capabilitățile și execută acțiuni neintenționate
- Otrăvirea instrumentelor, când un server MCP legitim returnează date controlate de atacator și inserează instrucțiuni în ieșiri care ar trebui să conțină doar date
- Instrumente cu privilegii excesive, când integrările MCP au permisiuni peste cerințele sarcinii
- Confuzia limitelor de încredere, când agentul tratează instrucțiunile instrumentelor MCP conectate ca pe instrucțiunile utilizatorului
Organizațiile care implementează agenți cu integrări MCP au nevoie de un cadru pentru evaluarea încrederii în serverele MCP, auditarea permisiunilor instrumentelor și verificarea faptului că răspunsurile acestora sunt tratate ca date, nu ca instrucțiuni.
Evaluarea este practica operațională omisă de certificări
Red teaming-ul AI și suitele de evaluare înlocuiesc evaluările statice de securitate ca metode principale de înțelegere a riscului modelelor înainte și după implementare.
Red teaming-ul AI implică:
- Testarea adversarială structurată a comportamentului modelului față de tehnici cunoscute de atac
- Benchmarking-ul jailbreakurilor pe seturi de date consacrate cu atacuri prin prompt
- Testarea robusteții adversariale, care măsoară variațiile ieșirii pentru intrări perturbate
- Testarea regresiei comportamentale între versiunile modelelor
- Evaluarea benchmarkurilor de siguranță pe suite de evaluare publicate
NIST, Anthropic, OpenAI, Microsoft, Google și CISA recomandă red teaming specific AI înainte de implementarea sistemelor cu risc ridicat. Aceasta devine o așteptare standard, nu o practică opțională.
Niciuna dintre certificările actuale de guvernanță AI nu pregătește suficient specialiștii să stabilească domeniul, să execute sau să interpreteze un exercițiu de red teaming pentru un model ori agent implementat. Ele descriu ce este red teaming-ul, dar nu te învață să-l faci.
Observabilitatea AI este o disciplină separată
Jurnalizarea tradițională de securitate nu se transferă direct la sistemele AI. Monitorizarea unui LLM sau agent în producție necesită colectarea și analiza altor date.
Infrastructura de observabilitate AI include:
- Telemetria prompturilor și a ieșirilor pentru detectarea anomaliilor și identificarea încălcărilor politicilor
- Jurnale ale apelurilor instrumentelor de către agenți, cu instrumentele apelate și argumentele folosite
- Monitorizarea calității recuperării în pipeline-urile RAG
- Detectarea și clasificarea tentativelor de jailbreak
- Monitorizarea consecvenței ieșirilor pentru detectarea driftului între versiunile modelului
- Urmărirea ratei halucinațiilor în aplicațiile unde acuratețea factuală contează
- Tipare de latență care pot indica încercări de prompt injection ce măresc dimensiunea contextului
Este o disciplină emergentă. În 2026, majoritatea organizațiilor care implementează AI au mult mai puțină observabilitate a componentelor AI decât a infrastructurii tradiționale. Majoritatea certificărilor de guvernanță nu descriu cum arată observabilitatea adecvată pentru sistemele AI.
Răspunsul la incidente AI nu seamănă cu IR obișnuit
Când un sistem tradițional este compromis, playbook-ul IR acoperă limitarea, analiza criminalistică și recuperarea. Incidentele AI introduc întrebări la care playbook-ul standard nu răspunde.
Pregătește playbook-uri pentru aceste întrebări înainte să ai nevoie de ele:
- Cum determini dacă un model a fost otrăvit în timpul fine-tuning-ului
- Cum evaluezi dacă o recuperare RAG a fost abuzată pentru a returna conținut controlat de atacator
- Cum identifici dacă un agent a executat acțiuni neautorizate și care a fost domeniul lor
- Cum verifici dacă o actualizare de model de la un furnizor terț a schimbat comportamentul într-un mod relevant pentru securitate
- Cum stabilești comportamentul modelului dinaintea incidentului pentru a-l compara cu cel de după
Acestea necesită pregătire anterioară incidentului, jurnale și telemetrie configurate în avans și runbook-uri specifice AI, care includ analiza criminalistică a comportamentului modelului, nu doar traficul de rețea și jurnalele endpointurilor.
Problema actualizării certificărilor
Un motiv structural pentru care certificările rămân în urma practicii este că securitatea AI evoluează mai repede decât permit ciclurile de actualizare.
Security+, CISSP și ISO 27001 acoperă domenii care evoluează de-a lungul anilor. Suprafețele principale de atac ale rețelelor, endpointurilor și aplicațiilor sunt relativ stabile. Tehnicile de atac asupra AI evoluează în luni. Tehnicile prompt injection, metodele de atac adversarial și suprafețele de atac agentic din 2026 diferă de cele existente când au fost lansate primele certificări AI, în 2023 și 2024.
Organismele de certificare actualizează materialele după programe stabilite. OWASP LLM Top 10 a publicat o revizie semnificativă în primul său an. MCP nu era o preocupare enterprise când au fost concepute multe certificări AI actuale. Cadrele de securitate AI agentică au apărut după majoritatea programelor curente.
Aceasta este o problemă structurală, nu o lipsă de intenție. Citește constant surse primare, în loc să tratezi o certificare ca pe un set fix de cunoștințe.
Ce ar trebui să conțină certificările de securitate AI
Pentru ca programele de certificare să reflecte practica actuală de securitate AI, trebuie să acopere:
- Apărare în profunzime împotriva prompt injection: filtrarea intrărilor, validarea ieșirilor, limitarea instrumentelor, izolarea și aprobarea umană, împreună cu limitele documentate ale fiecărei măsuri
- Verificarea lanțului de aprovizionare al modelelor: riscurile serializării nesigure, cerințe SBOM, documentarea provenienței și verificarea artefactelor semnate
- Arhitectura de securitate a agenților AI: limite de încredere, acces minim privilegiat la instrumente, reversibilitatea acțiunilor și cerințe de monitorizare
- Securitatea MCP și a integrărilor externe: evaluarea încrederii serverelor de instrumente, auditarea permisiunilor și separarea datelor de instrucțiuni
- Evaluare și red teaming: stabilirea domeniului unei evaluări adversariale, benchmarkurile și seturile de evaluare existente și interpretarea rezultatelor
- Observabilitatea AI: jurnalele și telemetria necesare sistemelor AI și folosirea lor pentru detectare și răspuns la incidente
- Răspunsul specific AI la incidente: planificarea scenariilor, colectarea probelor despre comportamentul modelului și considerente de recuperare specifice sistemelor AI
- Prevenirea scurgerilor de date: izolarea RAG, confidențialitatea prompturilor, controale de acces multi-tenant și filtrarea ieșirilor
Ce ar trebui să faci acum
Dacă răspunzi de sistemele AI din organizația ta:
Citește OWASP Top 10 for Large Language Model Applications și OWASP Agentic AI Top 10. Sunt gratuite și mai detaliate operațional decât programele actuale de certificare plătite.
Consultă MITRE ATLAS înainte de următoarea sesiune de modelare a amenințărilor pentru o componentă AI. Află ce tactici adversariale se aplică arhitecturii tale înainte de a finaliza proiectarea implementării.
Citește NIST AI 600-1. Extinde AI RMF de bază special pentru AI generativă și este mult mai relevant pentru implementările LLM și ale agenților decât cadrul de bază singur.
Consultă Google SAIF, Microsoft’s AI SDL și OWASP AI Exchange pentru îndrumări de inginerie pe care cadrele de guvernanță nu le oferă.
Verifică proveniența fiecărui model implementat de organizația ta. Consultă model cards. Scanează formatele de serializare pentru clase de exploatare cunoscute înainte de a încărca ponderile.
Evidențiază fiecare agent AI din mediul tău și accesul pe care îl are. Un agent cu drepturi de citire și scriere la baza de cunoștințe internă, e-mail și sistemul de fișiere amplifică efectele prompt injection. Limitează acreditările la ce necesită fiecare sarcină.
Solicită red teaming specific AI înainte de a implementa orice model sau agent într-un context cu consecințe importante. Tratează-l ca obligatoriu.
Construiește acum runbook-uri AI pentru răspunsul la incidente, înainte să ai nevoie de ele.
Tratează certificarea de guvernanță ca documentare a stratului de procese. Nu este documentarea poziției tale de securitate.
Referințe
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation