
În interiorul flotei noastre hibride de agenți IA: Hermes, LiteLLM și Tailscale

Table of Contents
Am implementat o flotă locală de GPU-uri alocate pentru fiecare solicitare și i-am proiectat planul de control hibrid. Calea verificată pornește din LiteLLM, selectează un grup de modele și încarcă un model local pe câte un GPU. Politica de niveluri Hermes este propusă, iar un artefact de configurare Tailscale Aperture este pregătit pentru următorul test de integrare. Niciuna nu a fost verificată ca parte a unei singure rute complete de la un capăt la altul.
Plăcile inactive minează Pearl. O solicitare de IA întrerupe minarea doar pe placa închiriată, deservește solicitarea, descarcă modelul și returnează placa minerului.
Idei principale
- T0 până la T2 gestionează lucrările costisitoare sau solicitante. Aceste rute preferă modelele avansate găzduite și lanțuri de rezervă ordonate.
- T3 gestionează lucrări locale substanțiale. Flota atribuie planificarea, programarea, revizuirea și viziunea modelelor de la 4B la 12B.
- T4 gestionează lucrări locale frecvente. Modelele mici rutează, clasifică, extrag, generează embeddinguri și finalizează sarcini de cod delimitate.
- Fiecare GPU este o resursă independentă. O placă deservește IA în timp ce celelalte continuă minarea.
- Modelele locale rămân descărcate când sunt inactive. Niciun model nu păstrează memorie GPU între ferestrele de solicitări.
- Fiecare gateway expune același catalog logic. Aliasurile partajate distribuie lucrul între sisteme eligibile. Aliasurile prefixate cu nodul păstrează amplasarea exactă când este nevoie.
- Brokerul experimental nu a ajuns în producție. Canary-ul său a deservit o solicitare, apoi a eșuat la testul de oprire curată. LiteLLM a rămas pe ruta verificată per solicitare.
- Hermes și Aperture sunt încă în pregătire. Proiectul-țintă există, dar testul de acceptare de la un capăt la altul rămâne deschis.
Cerințe preliminare: mai multe gazde Linux cu GPU, drivere NVIDIA stabile, un tailnet Tailscale, systemd, un miner funcțional, stocare pentru modele și teste de acceptare pentru fiecare rută de model.
Timp și dificultate: avansat. Alocați câteva zile pentru inventar, descărcarea modelelor, definițiile serviciilor, testele de rutare, exercițiile de defecțiune și verificările revenirii fiecărei plăci la minare.
Termeni folosiți mai jos: un tailnet este rețeaua privată formată din identități și dispozitive Tailscale. Un alias de model este un nume stabil de model prezentat clienților. Un grup de modele plasează mai multe implementări în spatele unui alias. Un proxy de pool este un serviciu local mic care închiriază un GPU, pornește workerul modelului și readuce placa la minare.
Obiectivul proiectului
Lucrul agentic are multe forme. Repararea unui depozit necesită un model diferit față de un titlu, o captură de ecran, un embedding sau o etichetă de intenție. Trimiterea fiecărui tur către cel mai mare model irosește bani și capacitate locală. Trimiterea fiecărui tur către cel mai mic model provoacă reîncercări și rezultate slabe.
Am dorit un singur catalog cu cinci benzi de sarcină. Politica trebuia să deservească modele găzduite și locale prin formate API cunoscute. GPU-urile locale trebuiau să rămână productive între solicitările IA.
Flota avea nevoie și de concurență. O gazdă cu mai multe plăci trebuia să deservească simultan mai multe lucrări independente. O solicitare pe o placă nu trebuia să oprească minarea pe toate plăcile din șasiu.
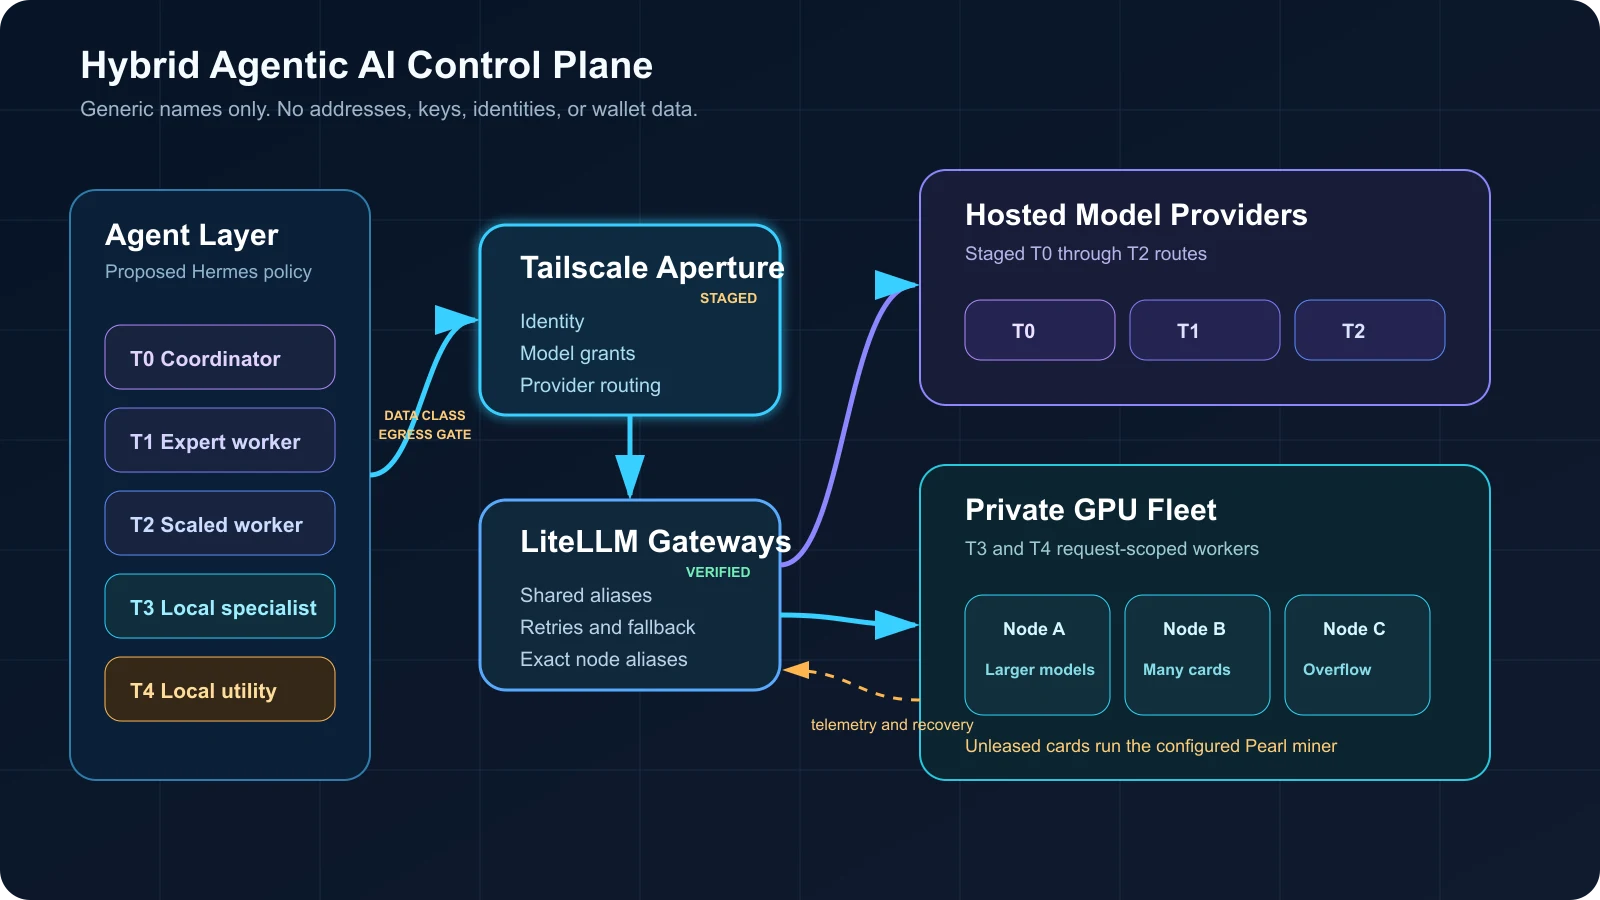
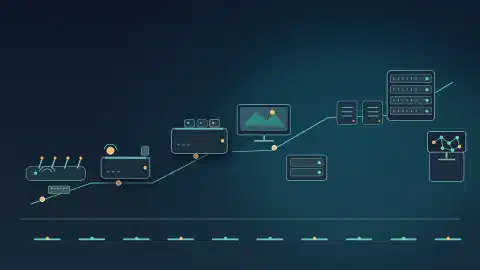
Calea de control propusă și cea în pregătire stau deasupra căii de execuție LiteLLM verificate pentru fiecare GPU
Diagrama folosește nume generice pentru noduri. Omite adrese private, identități ale utilizatorilor, chei de acces, date de portofel și etichete ale gazdelor fizice.
Ce înseamnă T0 până la T4
Denumirile nivelurilor reprezintă politica noastră de rutare. Nu sunt un standard industrial și nu descriu doar dimensiunea modelului.
| Nivel | Rol principal | Destinație obișnuită | Comportament la eșec |
|---|---|---|---|
| T0 | Coordonator implicit și cele mai dificile decizii | Model avansat de raționament găzduit | Lanț ordonat de rezervă găzduit |
| T1 | Agenți worker cu valoare ridicată | Pool găzduit de modele cu capabilități ridicate | Reîncercare în lanțul alocat |
| T2 | Pool general de workeri | Modele găzduite rapide, cu escaladare | Escaladarea lucrărilor dificile la T1 sau T0 |
| T3 | Lucrări locale private substanțiale | Modele locale de chat, cod, revizuire și viziune de la 4B la 12B | Reîncercare pe un nod local eligibil, apoi eșec sigur pentru date restricționate |
| T4 | Lucrări locale restrânse și frecvente | Modele locale de rutare, clasificare, cod și embedding de la 0,6B la 3B | Reîncercare pe o replică locală sau trecere la T3 în aceeași limită de date |
Nivelurile descriu sarcina înaintea modelului. O clasificare scurtă și sensibilă la securitate se potrivește cu T4. Un plan lung pentru un depozit se potrivește cu T3 sau mai sus. O decizie arhitecturală dificilă începe la un nivel superior chiar dacă promptul este scurt.
Această împărțire schimbă și economia agenților. Workerii T4 absorb transformări repetate cu risc scăzut. Workerii T3 păstrează codul comun și analiza în tailnet. T0 până la T2 rămân disponibile pentru lucrări dificile și recuperarea după defecțiuni.
Un filtru pentru clasa datelor trebuie să preceadă fiecare fallback găzduit. Lucrările publice, interne și restricționate primesc lanțuri separate. Lucrările restricționate rămân locale și eșuează în mod sigur. O reîncercare care trece limita necesită intrări sanitizate și aprobarea explicită a utilizatorului sau fluxului de lucru. Redactarea elimină datele de autentificare, secretele depozitului, rezultatele private ale instrumentelor și conținutul sensibil recuperat înainte de orice apel găzduit.
Cum va deține Hermes politica sarcinilor
Hermes este stratul de agenți propus. Politica-țintă atribuie o clasă de model, rulează instrumente, deleagă lucrări și parcurge lanțuri explicite de rezervă. Hermes documentează rute separate pentru modelul principal, lucrările auxiliare, agenții delegați și fallbackurile specifice sarcinii. Acceptă și endpointuri personalizate compatibile cu OpenAI printr-un URL de bază. Consultați ghidul de configurare Hermes și ghidul furnizorilor de fallback .
Politica noastră leagă sarcinile Hermes de aliasuri stabile, nu de servere fizice. Exemple:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Aliasul exprimă intenția. Hermes nu trebuie să știe ce GPU este liber, ce nod are o placă mai mare sau ce replică a eșuat la verificarea de sănătate. Straturile inferioare iau aceste decizii.
Unele lucrări au nevoie în continuare de amplasare deterministă. Un ID de model prefixat cu nodul trimite un diagnostic de operator sau un benchmark către un sistem selectat. Granturile Aperture separate ar trebui să limiteze aceste aliasuri la operatori. Traficul normal al agenților folosește aliasuri de nivel partajate.
Accesul la model nu securizează instrumentele agentului. Lansarea Hermes are nevoie de liste de permisiuni pentru instrumente cu privilegii minime, spații de lucru izolate, credențiale cu domeniu restrâns, controale pentru traficul de ieșire din rețea și tratarea injecției de prompt. Workerii delegați nu trebuie să moștenească mai mult acces decât cere sarcina lor.
Aperture este limita de identitate în pregătire
Tailscale conectează gateway-ul configurat și gazdele de inferență fără să publice fiecare serviciu pe internetul public. Aperture este pregătit ca limită orientată către utilizator și router de modele. Această rută mai are nevoie de un test de acceptare complet. Tailscale documentează accesul criptat al clienților prin tailnet și redirecționarea furnizorilor prin TLS în Cum funcționează Aperture .
Aperture separă și accesibilitatea de permisiune. Granturile sale refuză accesul implicit. După ce ajunge la gateway, un utilizator sau dispozitiv etichetat are nevoie de grantul corespunzător pentru model. Ghidul granturilor Aperture explică modelul aditiv al granturilor și sursele de identitate.
Înainte de implementare, configurația Aperture în pregătire ar trebui să urmeze patru reguli:
- O singură identitate nominalizată deține rolul de administrator. Accesul general la modele nu acordă administrare.
- Furnizorii enumeră ID-uri literale de modele. Aperture nu deduce modelele dintr-un serviciu upstream.
- URL-urile furnizorilor indică adrese din tailnet. Numele și adresele nodurilor private rămân în afara articolului și a exemplelor publice de configurare.
- Secretele rămân în fișiere deținute de serviciu. Înainte de implementare, aplică permisiuni numai pentru proprietar, conturi de serviciu restricționate, rotație și redactarea jurnalelor. Rezultatele de diagnostic nu trebuie să afișeze niciodată chei LiteLLM, adrese tailnet, tokenuri de abonament sau date de portofel.
Aperture adaugă calea solicitării primite la URL-ul de bază al fiecărui furnizor.
Referința de configurare
avertizează să nu se adauge un sufix /v1 duplicat la rădăcina furnizorului. Acest detaliu a creat suficient risc de integrare pentru a justifica o verificare explicită.
Viziunea este pregătită să folosească formatul OpenAI Chat Completions cu conținut imagine. Embeddingurile folosesc direct endpointul LiteLLM privat deoarece matricea actuală a furnizorilor auto-găzduiți Aperture documentează formatele de chat, în timp ce calea noastră de embedding depinde de endpointuri LiteLLM și llama.cpp din afara selectorului de chat. Consultați referința furnizorilor și clienților acceptați .
Calea directă de embedding are nevoie de propria limită de autorizare. Autentificarea LiteLLM, granturile Tailscale restrictive, legarea serviciului la interfața tailnet și regulile firewall-ului gazdei ar trebui să limiteze accesul la identități sau etichete de serviciu aprobate. O adresă privată, singură, nu este o politică de autorizare.
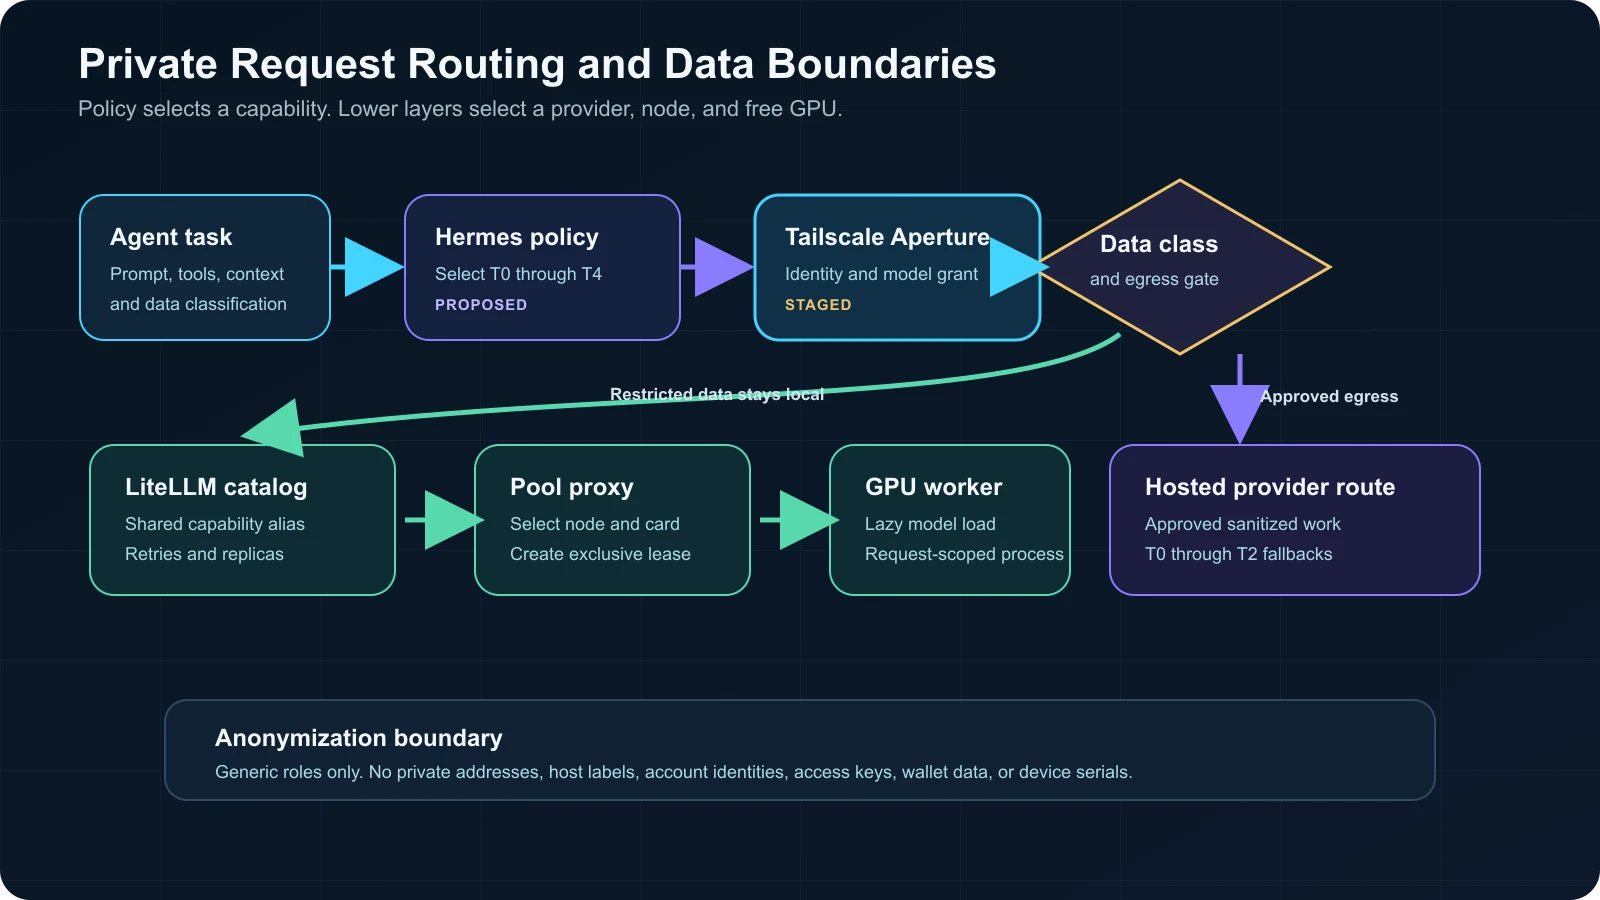
Identitatea, granturile și clasificarea datelor decid dacă o solicitare părăsește flota privată
LiteLLM prezintă un singur catalog
Fiecare gazdă de inferență rulează un gateway LiteLLM. Fiecare gateway expune același catalog logic de modele, chiar dacă un model este pe alt nod. Clientul păstrează o singură formă API și un singur set de aliasuri.
LiteLLM grupează mai multe implementări sub un nume de model. Routerul selectează apoi o implementare eligibilă și aplică reîncercări, expirări, perioade de așteptare sau fallbackuri. Documentația actuală de rutare LiteLLM descrie numele comune de modele, strategiile de rutare și comportamentul reîncercărilor.
Catalogul are două stiluri de adrese:
| Stil de adresă | Exemplu | Utilizare |
|---|---|---|
| Alias partajat | t4-classify | Distribuie lucrările obișnuite între nodurile eligibile |
| Alias de nod | node-b/qwen-small | Rulează diagnostice sau păstrează amplasarea |
Aliasurile partajate oferă scalare orizontală fără să schimbe Hermes. Adăugarea unei replici eligibile extinde grupul de modele. Eliminarea unei replici cu probleme restrânge grupul.
Păstrăm logica ciclului de viață GPU sub LiteLLM. Gateway-ul rămâne activ deoarece amprenta sa de memorie nu rezervă memorie GPU. Un proxy de pool local primește solicitarea modelului selectat, închiriază o placă, pornește workerul și îl oprește după răspuns.
Catalogul local de modele
Flota preferă modelele cu cel mult 12B parametri. Limita se potrivește cu memoria plăcilor disponibile și lasă loc pentru context și buffere de execuție.
Notația modelelor: B înseamnă miliarde de parametri. K înseamnă mii de tokenuri de context configurate. Cuantizarea stochează ponderile modelului la precizie numerică redusă pentru a micșora utilizarea memoriei. Cache-ul KV păstrează starea de atenție pentru contextul activ și crește cu lungimea promptului. E4B este eticheta Google pentru dimensiunea variantei Gemma 4 mai mici.
| Rută de nivel | Clasă de model | Context configurat | Lucrare principală | Amplasare |
|---|---|---|---|---|
| T3 inteligent | Qwen3.5 9B, cuantizat | 64K | Planificare locală dificilă și activități generale de agent | Noduri GPU cu memorie mai mare |
| T3 cod | Granite 4.2 8B, cuantizat | 64K | Lucru în depozite, instrumente, terminal și ieșire structurată | Noduri GPU cu memorie mai mare |
| T3 revizuire | Gemma 4 12B, cuantizat | 32K | Revizuire independentă și raționament alternativ | Noduri GPU cu memorie mai mare |
| T3 general și viziune | Qwen3.5 4B, cuantizat | 32K | Lucrări generale la scară și înțelegerea imaginilor | Toate GPU-urile compatibile |
| T3 revizuire alternativă | Gemma 4 E4B, cuantizat | 8K | Cale diversă de revizuire | Toate GPU-urile compatibile |
| T4 cod | Granite 4.2 3B, cuantizat | 16K | Editări mici, apeluri de instrumente, ieșire structurată | Toate GPU-urile compatibile |
| T4 clasificare | Qwen3.5 2B, cuantizat | 16K | Clasificare, extragere și rescriere | Toate GPU-urile compatibile |
| T4 router | Qwen3.5 0.8B, cuantizare de înaltă precizie | 16K | Intenții, etichete, titluri și transformări scurte | Toate GPU-urile compatibile |
| T4 embedding | Qwen3 Embedding 0.6B, cuantizat | 32K | Memorie de agent, RAG, recuperare de cod și grupare | Toate GPU-urile compatibile |
Aceste valori de context sunt setări de implementare, nu limitele declarate ale modelelor. O fereastră declarată mai mare consumă în continuare cache KV și memorie de execuție. Am ales valori mai mici pentru servicii stabile pe o singură placă.
Qwen descrie Qwen3.5 drept familie multimodală și publică variante dense, de la mici la mari, în colecția Qwen3.5 . IBM publică rezultate de programare agentică și context lung pentru Granite 4.2 8B . Google notează că Gemma 4 acceptă intrări multimodale, apeluri de funcții și o fereastră declarată mai mare.
Ruta de embedding folosește un model separat în loc să ceară vectori unui model de chat. Fișa modelului Qwen3 Embedding 0.6B indică secvență de 32K, recuperare multilingvă și de cod, precum și dimensiuni de ieșire de până la 1.024.
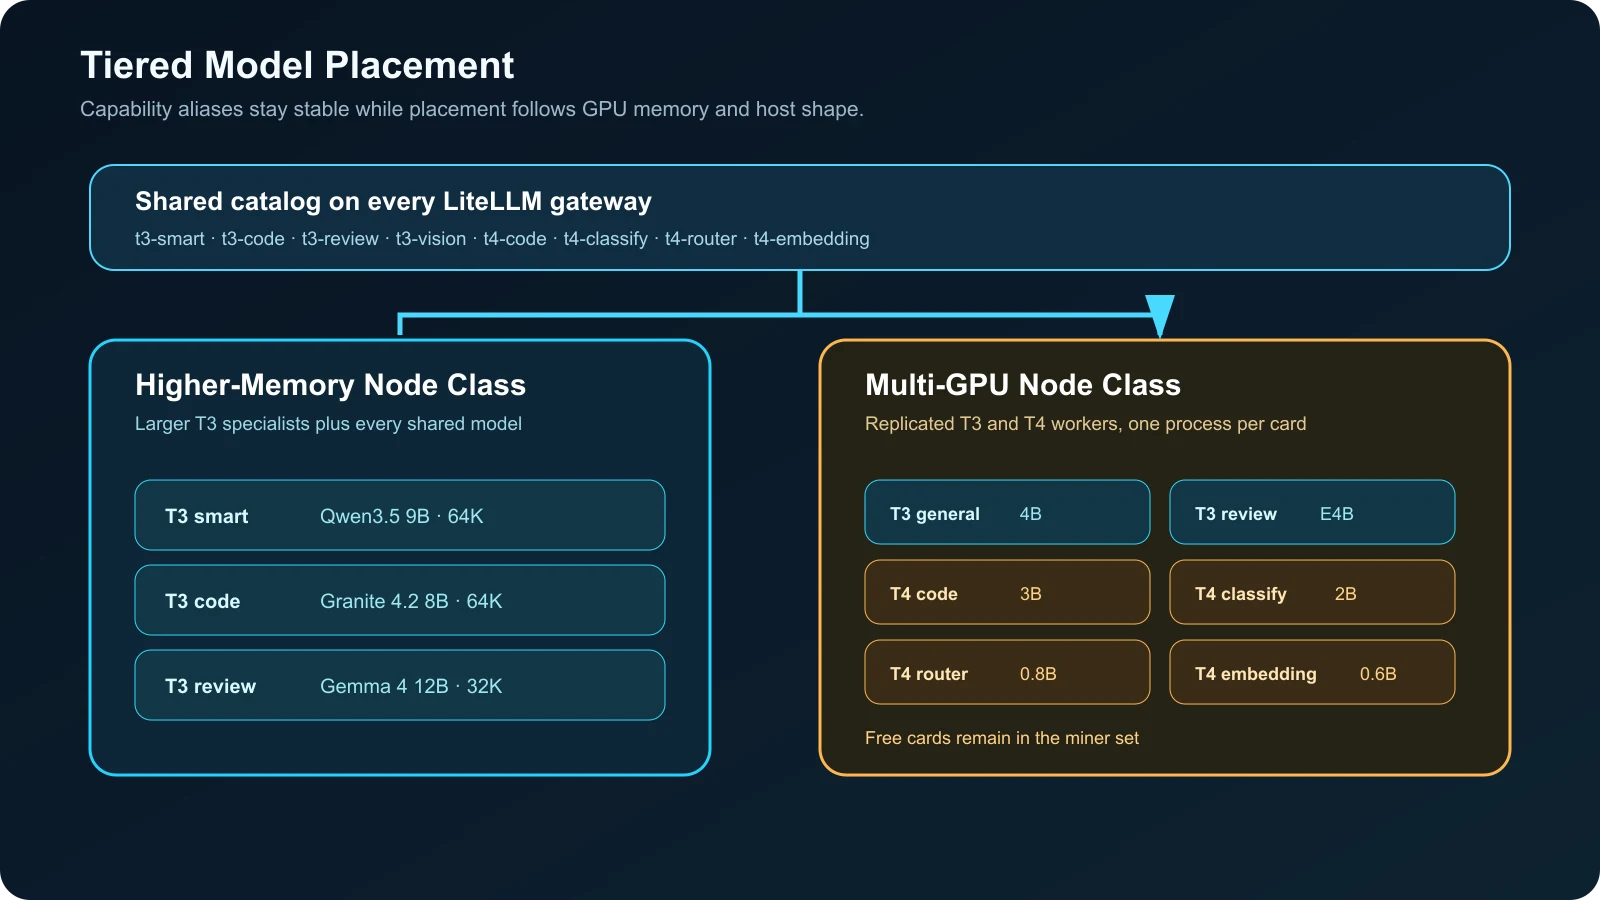
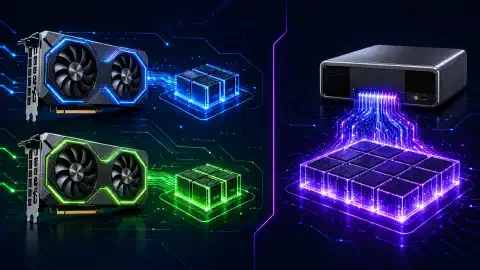
Specialiștii mai mari rămân pe plăci cu mai multă memorie, iar cei mai mici se replică în flotă
De ce llama.cpp rulează în producție
llama.cpp se potrivește cu modelul resurselor. Un worker static corespunde unui GPU, unui fișier de model, unui context configurat și unui lease. Separarea proceselor simplifică auditarea pornirii, închiderii, vizibilității GPU și jurnalelor.
Serverul său expune chat, răspunsuri și embeddinguri compatibile cu OpenAI. Acceptă și decodare paralelă și batching continuu. Documentația actuală a serverului marchează suportul multimodal ca experimental. Aceste funcții apar în documentația serverului llama.cpp .
Ollama rămâne disponibil ca rută de compatibilitate pe un nod mai mare. Ollama acceptă încărcarea concurentă a modelelor când memoria permite și descărcarea imediată prin keep_alive: 0, conform
FAQ-ului Ollama
. Nu am ales Ollama pentru ruta de producție per placă deoarece workerii statici llama.cpp oferă control mai strict asupra amplasării și închiderii.
Am analizat și Strata. Strata vizează un model mare Qwen mixture-of-experts distribuit între memoria GPU, RAM-ul sistemului și stocare. Preseturile publicate pornesc de la 32 GB de memorie combinată, iar modul cu RAM redus schimbă viteza pentru capacitate mai mică. Consultați depozitul Strata . Strata servește altui obiectiv: un model hibrid mai mare pe una sau mai multe plăci. Flota noastră preferă mulți workeri independenți sub 12B.
Încărcare la cerere per GPU
Încărcarea la cerere se aplică fiecărui worker de model. Între solicitări, sistemul menține active doar gateway-urile, proxy-urile de pool, watchdog-urile și minerul.
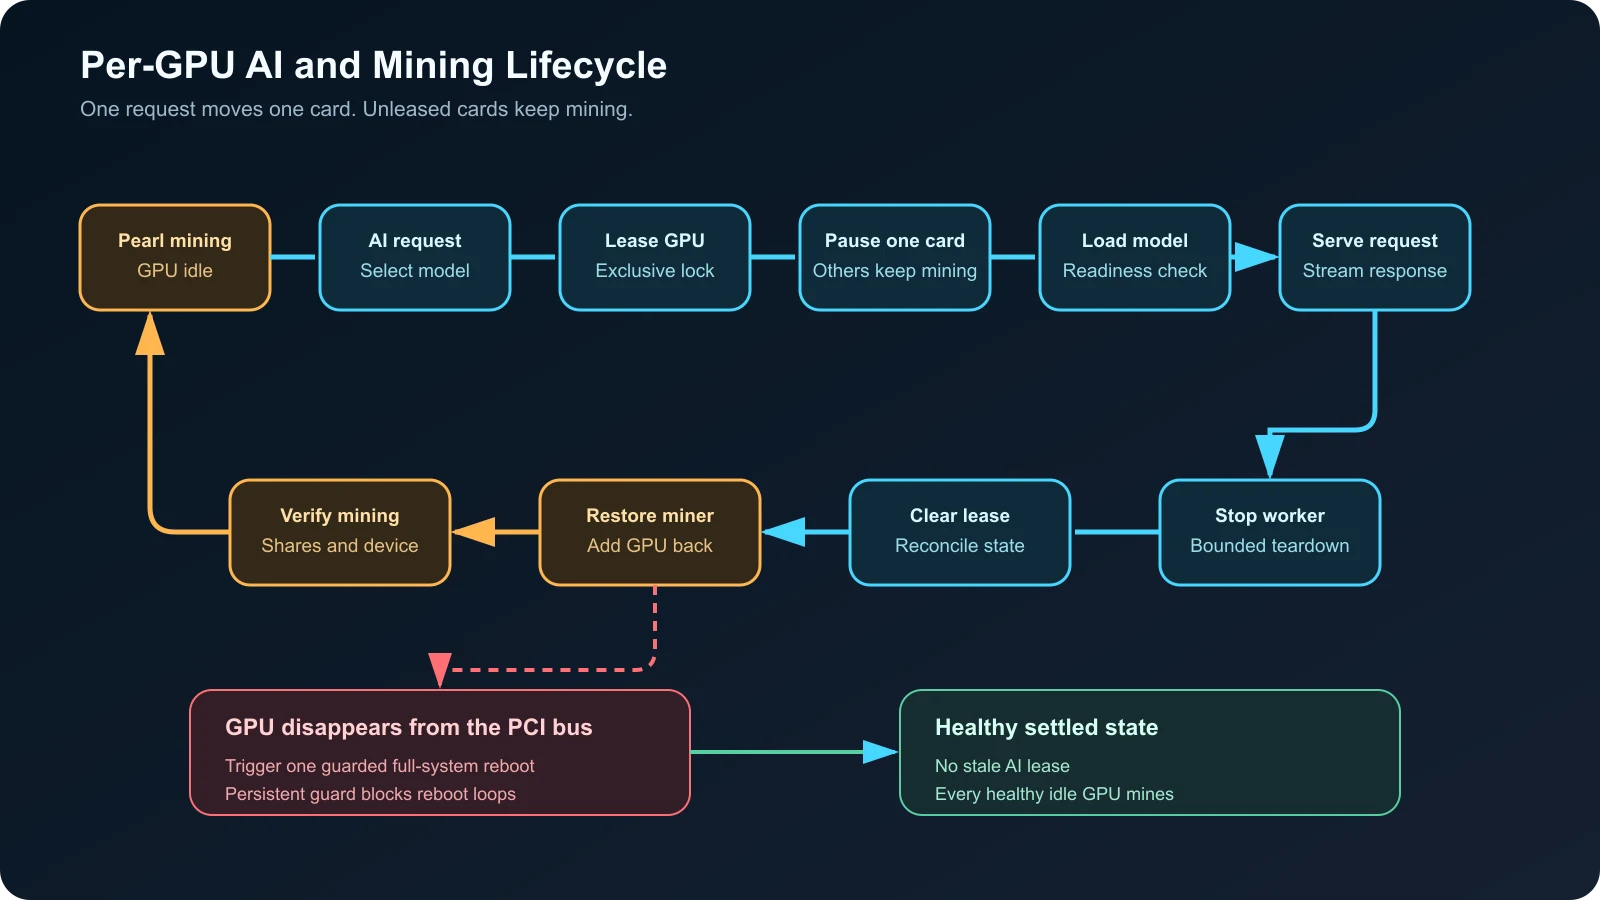
Doar placa închiriată părăsește minerul și revine după ce procesul modelului se oprește
Ciclul de viață al solicitării urmează acești pași:
- LiteLLM selectează o implementare. Solicitarea ajunge la proxy-ul de pool pentru clasa de model selectată.
- Pool-ul obține un lease. Un blocaj împiedică doi workeri exclusivi să preia aceeași placă.
- Minerul repornește fără un GPU. Fiecare placă neînchiriată rămâne în comanda Pearl.
- llama.cpp pornește pe dispozitivul închiriat. Verificările de pregătire se încheie înainte ca proxy-ul să transmită solicitarea.
- Workerul oferă răspunsul. Solicitările concurente pornesc workeri pe alte plăci libere.
- Workerul se oprește. Pool-ul elimină lease-ul după închiderea procesului.
- Minerul repornește cu GPU-ul eliberat. Verificările de sănătate confirmă că placa a revenit la minare.
Acest lucru diferă de comutarea întregii gazde. Un șasiu cu mai multe plăci deservește mai multe modele în timp ce plăcile rămase minează. Când flota este inactivă, fiecare GPU sănătos revine la Pearl.
Cartea albă Pearl descrie sistemul său de dovadă prin calcul matricial. Arhitectura noastră nu se bazează pe prognoze de profitabilitate și nici pe promisiuni privind randamentul economic. Minarea este sarcina configurată pentru perioadele inactive.
Gestionarea defecțiunilor contează mai mult decât pornirea
Pornirea modelului acoperă doar jumătate din ciclu. Opririle forțate, GPU-urile dispărute, solicitările întrerupte, lease-urile vechi și repornirile minerului necesită tratare explicită.
Watchdog-ul nostru compară setul configurat de GPU-uri cu lista live de dispozitive NVIDIA. Confirmarea unui GPU lipsă declanșează o singură repornire completă a sistemului, cu protecții. Un declanșator sigur pentru producție ar trebui să ceară verificări eșuate repetate, o perioadă de așteptare, oprirea lucrărilor active, un contor persistent de reporniri și o alertă la distanță. O recuperare eșuată ar trebui să oprească automatizarea și să ceară intervenție manuală.
Același watchdog reconciliază lease-urile vechi. Dacă niciun worker nu deține un lease, reconcilierea șterge înregistrarea veche și readuce GPU-ul la miner. Această cale de recuperare a contat în timpul canary-ului brokerului.
| Defecțiune | Răspuns |
|---|---|
| Modelul eșuează la verificarea de pregătire | Oprește workerul, eliberează lease-ul, restabilește minarea și returnează o eroare |
| Solicitarea se încheie neașteptat | Limitează durata curățării, termină arborele de procese al workerului și reconciliază lease-ul |
| GPU-ul dispare | Confirmă absențe repetate, oprește lucrările active, execută o repornire protejată, alertează, apoi verifică întregul set configurat de GPU-uri |
| Minerul omite o placă inactivă | Reface lista dispozitivelor din lease-urile active și repornește minerul |
| Implementarea LiteLLM eșuează | Încearcă altă replică din același grup de modele, apoi urmează politica de fallback |
| Un grant Aperture blochează o rută | Repară identitatea sau grantul modelului, fără să ocolească politica gateway-ului |
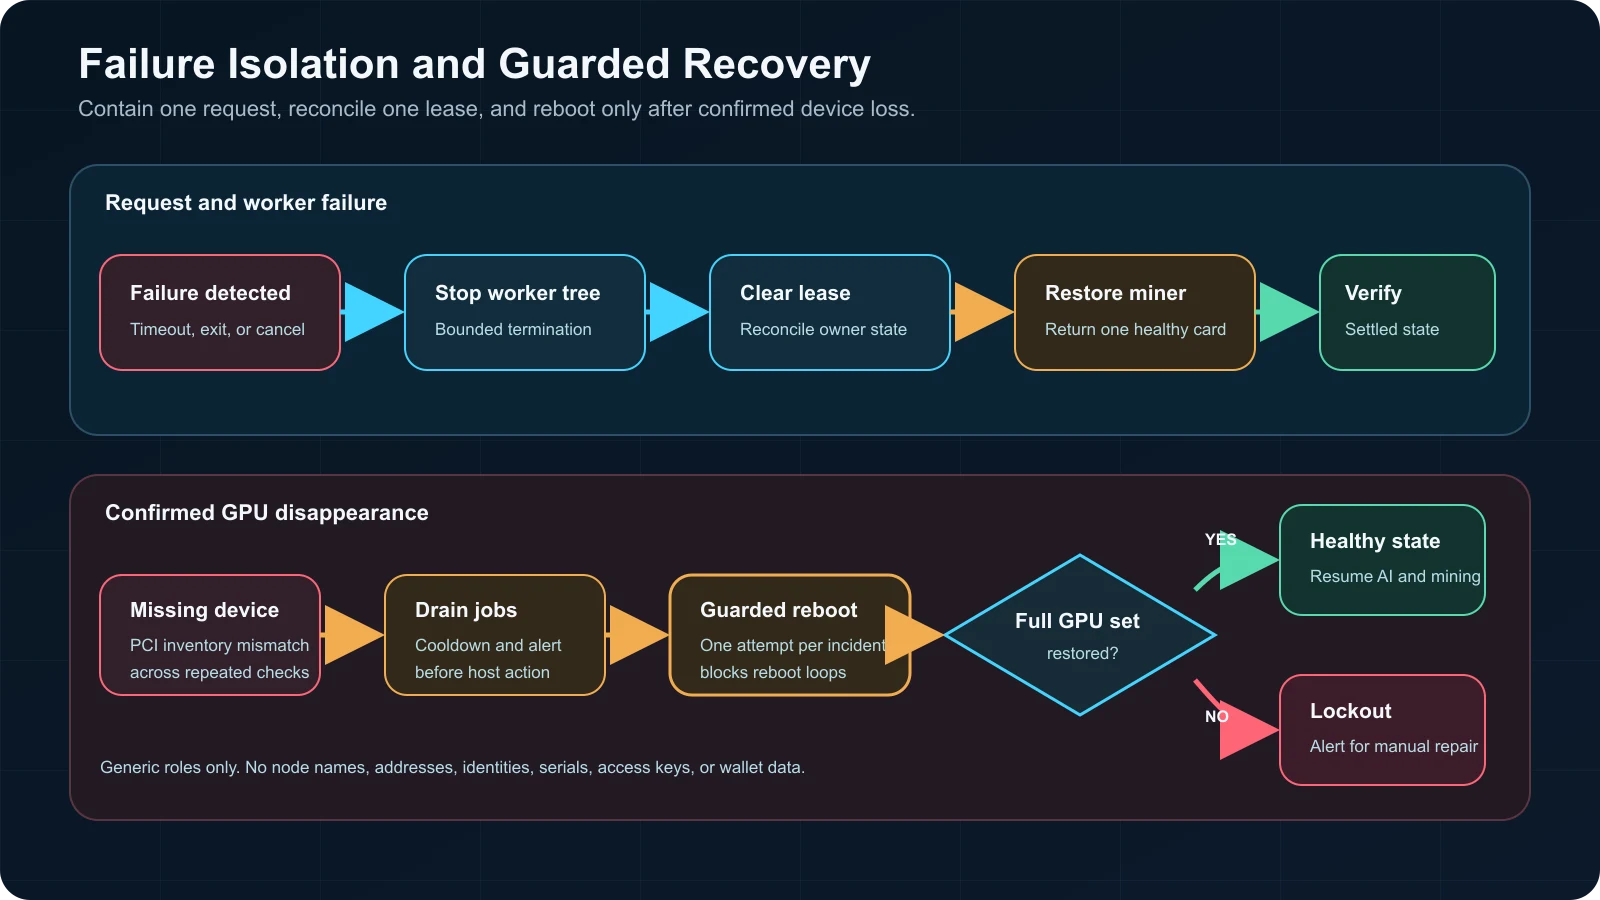
Defecțiunile obișnuite eliberează un lease, iar pierderea confirmată a dispozitivului intră în calea protejată de recuperare a gazdei
Ce s-a întâmplat cu brokerul experimental
Brokerul agnostic la backend urmărește să ofere o singură interfață compatibilă cu OpenAI pentru Ollama, vLLM, llama.cpp și Strata. Include gestionarea ciclului de viață per model, descărcarea în repaus și amplasarea GPU.
Am testat brokerul versiunea 0.6.0 la commitul c12b65 pe 21 octombrie 2026. Suita locală a raportat 1.101 teste trecute și 2 omise, fără probleme Ruff. Canary-ul a încărcat apoi un model la cerere și a deservit o solicitare chat cu succes. Celelalte GPU-uri au continuat să mineze în timpul solicitării.
Oprirea a dezvăluit o problemă critică de ciclu de viață. După încărcarea modelului, brokerul rămânea în procesul de oprire până când systemd omora arborele de procese. Oprirea forțată a lăsat un lease GPU vechi până la reconcilierea care a restabilit minerul. Am găsit și o diferență între setarea documentată pentru GPU obligatoriu și impunerea ei în adaptorul de producție.
Am dezactivat brokerul în calea de producție. LiteLLM rutează acum prin proxy-ul de pool per solicitare. Brokerul rămâne experimental până când oprirea limitată a proceselor copil, terminarea grupurilor de procese, verificările de admitere a GPU-ului obligatoriu și curățarea lease-urilor vechi trec testele de integrare.
Rezultatul oferă o lecție inginerească utilă. Un broker demonstrează puțin când pornește un model o singură dată. Pregătirea pentru producție depinde de închidere curată, recuperare limitată, admitere exclusivă a dispozitivului și exerciții repetabile de defecțiuni.
Verificările efectuate
Testul de implementare a acoperit mai mult decât un răspuns de model:
- Fiecare model chat partajat a completat ciclul de încărcare, răspuns, ieșire și recuperare Pearl pe cel puțin o gazdă eligibilă.
- Viziunea a acceptat intrare imagine prin ruta chat.
- Embeddingurile au returnat dimensiunea vectorului configurat prin ruta LiteLLM privată.
- Mai multe modele au rulat simultan pe plăci separate.
- Plăcile neînchiriate au rămas la miner în timpul solicitărilor IA concurente.
- Aliasurile partajate au rutat între noduri eligibile.
- Aliasurile prefixate cu nodul au păstrat amplasarea deterministă.
- Fiecare gateway LiteLLM a listat același catalog logic.
- Un GPU lipsă a fost recuperat după o repornire completă a gazdei. Watchdog-ul are acum o protecție persistentă pentru bucle.
- O defecțiune de oprire a brokerului a fost recuperată prin reconcilierea lease-ului.
- Starea finală stabilă nu avea lease-uri IA, iar fiecare GPU sănătos revenise în setul minerului.
Verificările de sănătate și listele de modele nu au fost tratate drept teste de încărcare a modelului. Un test de acceptare util trimite o solicitare reală, verifică răspunsul, confirmă GPU-ul selectat, urmărește oprirea și verifică revenirea la minare.
Depanarea flotei
| Simptom | Prima verificare |
|---|---|
| Modelul apare, dar solicitările eșuează | ID-ul modelului upstream, formatul API, antetul de autentificare și URL-ul de bază al furnizorului |
| Aperture returnează 405 | Rădăcina furnizorului nu are sufix /v1 duplicat |
| Nodul greșit deservește solicitarea | Alias partajat sau alias prefixat cu nodul |
| Doi workeri vizează aceeași placă | Blocarea lease-ului, starea lease-ului vechi și logica de admitere GPU |
| Minarea se oprește pe toate plăcile | Codul de repornire al minerului construiește lista dispozitivelor din lease-urile active |
| GPU-ul rămâne în afara minării | Arborele proceselor workerului, reconcilierea lease-ului și lista dispozitivelor minerului |
| Încărcarea la rece este lentă | Dimensiunea modelului, viteza stocării, lățimea legăturii PCIe și presiunea CPU a gazdei |
| Prompturile lungi eșuează | Contextul configurat, spațiul disponibil pentru cache KV și rezerva de ieșire |
| Ruta de embedding lipsește din Aperture | Folosește ruta LiteLLM autentificată, restricționată de identitatea Tailscale și politica firewall-ului gazdei |
| Oprirea brokerului se blochează | Dezactivează ruta brokerului și întoarce traficul la proxy-ul de pool verificat |
Reguli de proiectare care merită păstrate
- Rutează după scopul sarcinii. Mărimea modelului nu definește singură un nivel.
- Păstrează politica deasupra amplasării. Hermes selectează un alias de capabilitate. LiteLLM selectează o implementare. Pool-ul selectează un GPU.
- Tratează fiecare GPU drept un lease separat. Comutarea întregii gazde irosește plăcile disponibile.
- Descarcă toate modelele inactive. Gateway-urile active nu au nevoie de workeri GPU activi.
- Păstrează o cale restricționată de amplasare exactă. Aliasurile de nod doar pentru operatori fac diagnosticele reproductibile.
- Testează mai întâi oprirea. Recuperarea minerului și curățarea lease-urilor fac parte din testele de acceptare.
- Separă chatul, viziunea și embeddingurile. Un gateway nu implică o singură cale de protocol.
- Ține detaliile private în afara diagramelor. Publică roluri și fluxuri, nu adrese, chei, identități sau date de portofel.
- Protejează logica repornirii. Cere absențe repetate, perioadă de așteptare, contor persistent, alertă și intervenție manuală după o recuperare eșuată.
- Păstrează un ocol experimental. Eșecul brokerului nu ar trebui să tragă după sine calea verificată.
Pașii următori
Următoarea fază evaluează sarcinile. Fiecare nivel are nevoie de un set fix de sarcini, criterii de acceptare, înregistrări de latență, ocuparea GPU, timpul de întrerupere a minării și rate de escaladare. Măsurătorile vor arăta ce sarcini T2 se potrivesc cu T3 și ce sarcini T3 încap în T4.
Planificăm și primul test de acceptare Hermes prin Aperture prin LiteLLM, apoi vom retesta brokerul după repararea căilor de oprire și admitere GPU. Generarea imaginilor are nevoie de propriul adaptor compatibil cu OpenAI și cu încărcare la cerere înainte de a intra în același catalog de rutare.
Pentru dimensionarea modelelor, citește ghidul de context pentru modele locale IA și GPU . Pentru limitele de confidențialitate, citește Confidențialitatea și securitatea IA locale . Pentru configurarea și riscurile minerului, citește ghidul de minare Pearl în loc să tratezi minarea în repaus ca profit garantat.

Related Posts