Este suficientă memoria VRAM de 16 GB pentru lucrul serios cu un LLM local?
Table of Contents
16 GB de memorie GPU dedicată susțin lucrul serios cu un LLM local atunci când modelul, contextul și runtime-ul încap împreună. Încărcarea greutăților dovedește doar prima cerință. Un sistem util are nevoie și de memorie pentru conversația curentă și de viteză suficientă pentru a termina sarcina.
Folosește Qwen3.8 27B ca exemplu pentru dimensionarea unui flux de lucru de programare sau documente pentru un singur utilizator. Începe cu contextul cerut de sarcină, apoi alege greutăți și setări runtime care încap în memoria rămasă. Specificațiile hardware și sursele modelului au fost verificate la 7 octombrie 2026.
Idei principale
- Rezervă memorie pentru context înainte de a alege o cuantizare.
- Măsoară procesarea promptului separat de viteza de ieșire.
- Dezactivează suportul vizual nefolosit și testează un cache KV de 8 biți.
- Compară GPU-ul exact, backend-ul, fișierul modelului și lungimea promptului.
- Calculează economiile de deținere pornind de la volumul tău de lucru și factura furnizorului.
Pentru exercițiul de dimensionare ai nevoie de jurnalul de memorie al runtime-ului, numele exact al fișierului modelului și o sarcină reprezentativă. Rezervă aproximativ 20 de minute pentru configurare și înregistrarea rezultatelor, plus timpul de inferență. Dificultatea este intermediară.
Potrivește memoria cu activitatea
16 GB se potrivesc unui volum de lucru în care greutățile, contextul activ și alocările temporare rămân în memoria GPU disponibilă. Contextul necesar depinde de sarcină. Un rezumat scurt de document și un agent de programare care citește zeci de fișiere au bugete diferite.
| Volum de lucru | Prima întrebare de dimensionare |
|---|---|
| Chat scurt sau redactare | Modelul atinge ținta de calitate? |
| Analiza documentelor | Textul sursă și răspunsul încap împreună? |
| Agent de programare | Cât context consumă fișierele și rezultatele instrumentelor? |
| Cereri concurente | De cât cache are nevoie fiecare sesiune activă? |
O fereastră configurată diferă de una ocupată. Un benchmark cu limită de 64K și prompt scurt nu măsoară generarea după 55K tokenuri de conversație. Testează aproape de lungimea așteptată a sesiunii înainte să alegi hardware-ul.
De ce încape modelul
Cuantizarea stochează greutățile cu mai puțini biți. Tabelul de fișiere Qwen3.8 27B al lui Bartowski listează Q4_K_M la 17,44 GB, deja peste aproximativ 17,18 miliarde de octeți ai unui dispozitiv de 16 GiB înainte de memoria runtime.
Fișa modelului GSQ-RCO de la ISTA-DASLab listează IQ3_S la 11,8 GB. Metoda atribuie precizii diferite tensorilor diferiți în limita unui buget de dimensiune. Versiunea MTP opțională adaugă aproximativ 0,35 GB, iar proiectorul vizual aproximativ 0,9 GB.
| Benchmark publicat | Scor BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Laboratorul numește acest punct de funcționare „task-lossless”. Rezultatele susțin o comparație îngustă. Nu dovedesc răspunsuri identice, recuperare egală în contexte lungi sau fiabilitate egală în sarcinile tale de programare. Testează modelul comprimat după propriile criterii de acceptare.
Numără cache-ul
Cache-ul KV păstrează cheile și valorile de atenție pentru tokenurile procesate deja. Promptul, rezultatele instrumentelor și răspunsurile generate consumă context. Unele runtime alocă capacitatea cache-ului la pornire, astfel încât memoria afișată nu trebuie să crească la fiecare mesaj.
Configurația Qwen specifică 64 de straturi, atenție completă la fiecare al patrulea strat, patru capete KV și o dimensiune a capului de 256. Pentru cele 16 straturi cu atenție completă, costul calculat al cache-ului FP16 este:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Calculul exclude starea recurentă, alinierea, bufferele temporare și alocările pentru decodarea speculativă. Alte arhitecturi cer alte calcule.
| Tokenuri ocupate | Cache FP16 cu atenție completă |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Aici, KiB și GiB folosesc puteri ale lui 1024. Dimensiunile descărcărilor modelului folosesc GB zecimali. Amestecarea unităților denaturează bugetul rămas.
Bugetează contextul disponibil
Două setări eliberează memorie pentru sesiuni de text mai lungi: elimină un proiector vizual nefolosit și redu precizia cache-ului. Calculează efectul lor față de modelul încărcat și alocările runtime.
Folosește acest exemplu, cu fiecare alocare exprimată în GB zecimali. Rezerva de 1,0 GB este o presupunere de planificare, nu o valoare implicită universală a runtime-ului.
| Alocare | Vizual activat / dezactivat |
|---|---|
| Capacitate fizică de 16 GiB | 17.180 / 17.180 GB |
| Greutățile modelului | 11.800 / 11.800 GB |
| Cap MTP opțional | 0.350 / 0.350 GB |
| Estimarea proiectorului vizual | 0.930 / 0 GB |
| Alte alocări presupuse | 1.000 / 1.000 GB |
| Disponibil pentru cache în creștere | 3.100 / 4.030 GB |
La 65.536 de octeți per token, 3,100 GB conțin aproximativ 47.300 de tokenuri. Cu stocare ideală de 8 biți, ar fi nevoie de 32.768 de octeți per token și ar încăpea aproximativ 123.000 de tokenuri cu vederea dezactivată.
Stocarea q8_0 reală include scale de bloc. La 34 de octeți pentru 32 de valori, exemplul are nevoie de aproximativ 34.816 octeți per token, reducând estimarea la aproximativ 115.700. Alocările suplimentare reduc rezultatul. Aproximativ 110K este astfel un rezultat plauzibil de planificare în aceste condiții, nu o setare garantată.
Contextul rămas trebuie să acopere intrarea și ieșirea. Cu o fereastră de 65.536 de tokenuri, un prompt inițial ilustrativ de 30.000 de tokenuri și o alocație de ieșire de 8.192 lasă 27.344 de tokenuri pentru fișiere, rezultate ale instrumentelor și conversație. Bugetul promptului inițial este un exemplu. Măsoară propriile instrumente și instrucțiuni.
Setări care merită testate
Documentația serverului llama.cpp descrie tipuri separate pentru cache-ul de chei și valori, încărcarea automată a proiectorului și sloturi paralele. Pentru un volum de lucru doar cu text, testează vederea dezactivată, q8_0 pentru ambele tipuri de cache și un slot. Începe cu un context moderat.
Înregistrează alocările înainte de a crește contextul. Cuantizarea cache-ului cere suport din partea arhitecturii și backend-ului ales. Testează calitatea răspunsului după schimbarea preciziei. Păstrează o configurație funcțională pentru comparație.
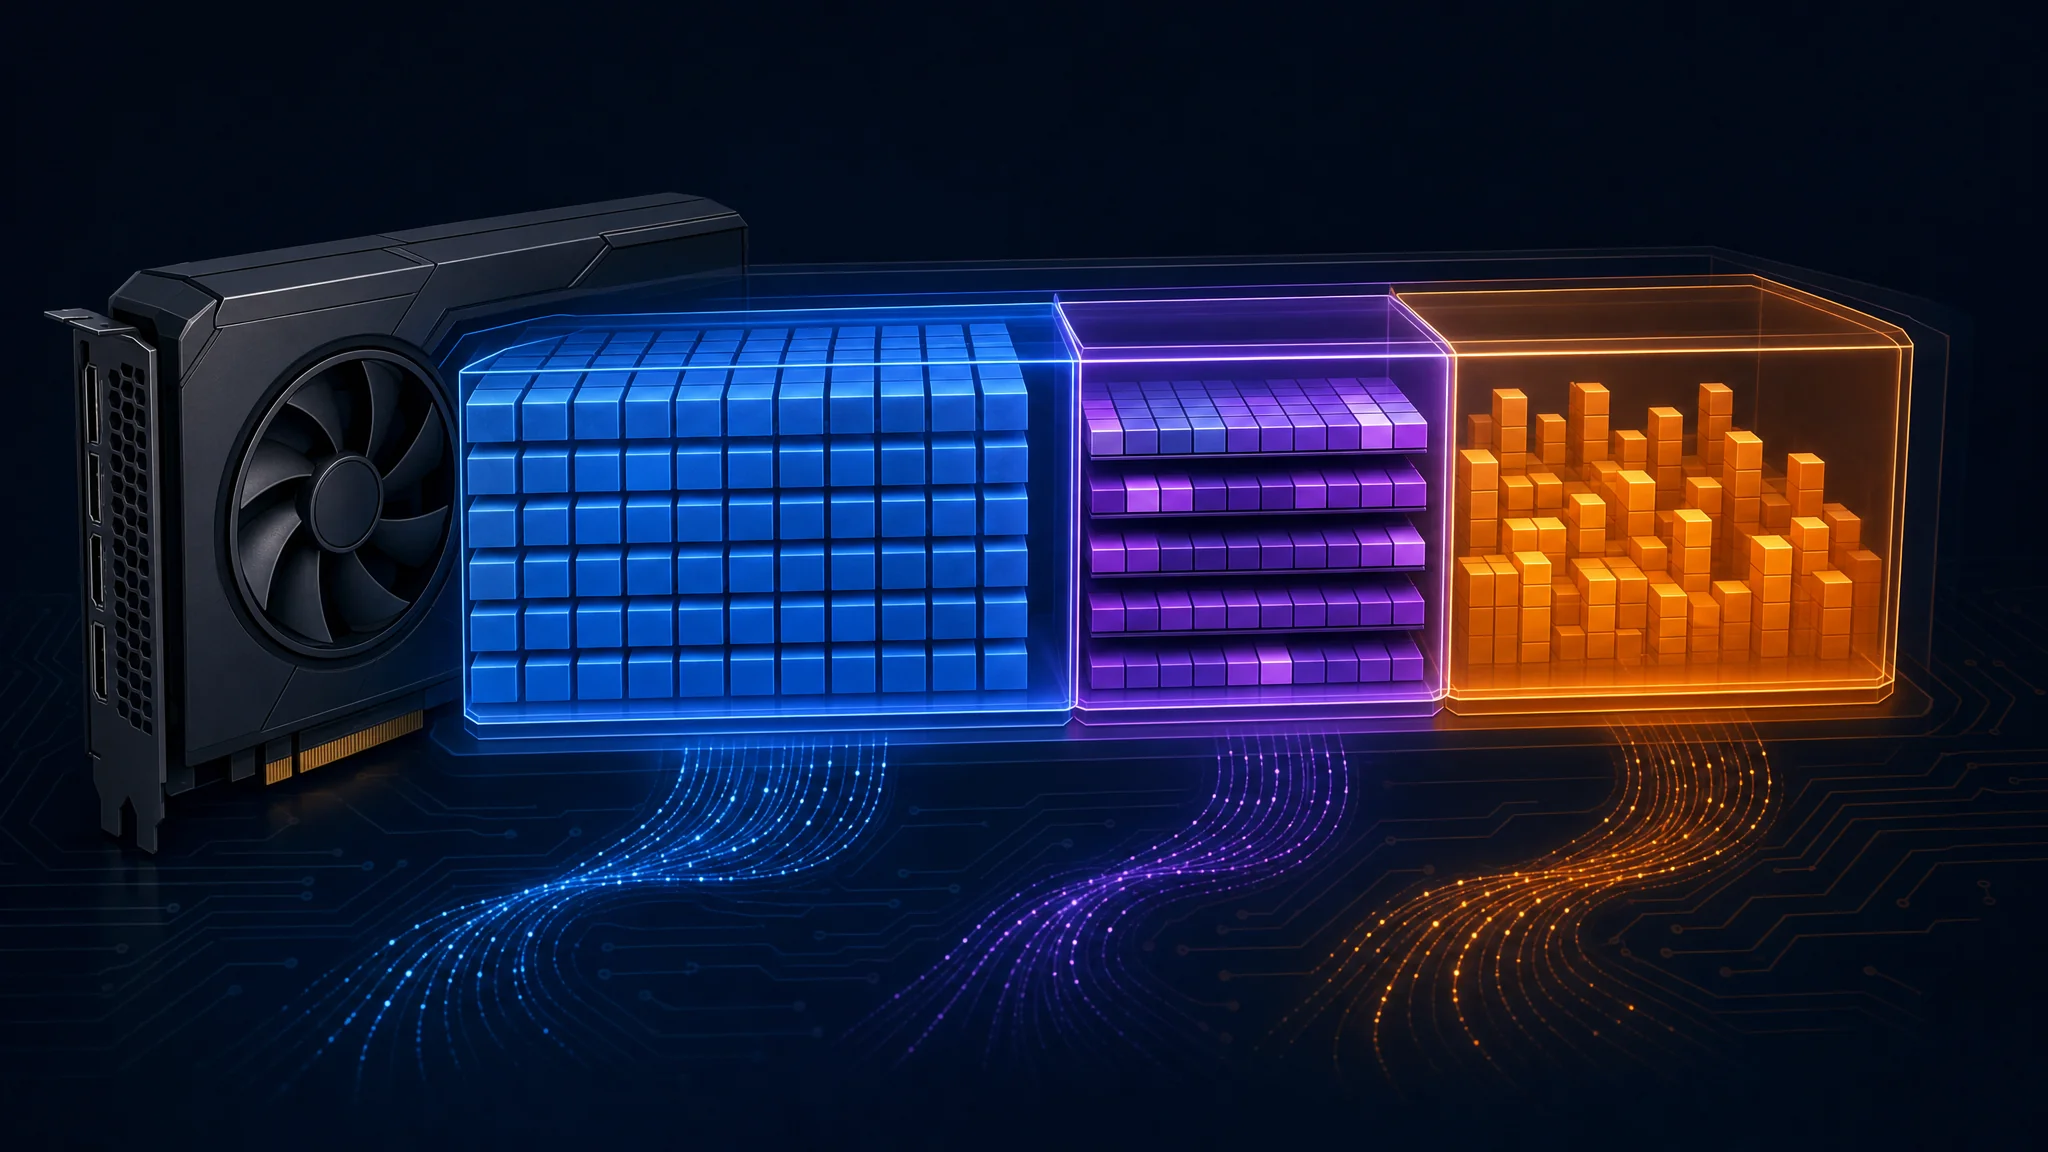
Albastrul reprezintă greutățile, movul cache-ul de context, iar portocaliul alocările runtime. Dimensiunile sunt ilustrative
De ce diferă vitezele
Eticheta de 16 GB descrie capacitatea. Debitul depinde și de lățimea de bandă a memoriei, kernelurile de calcul, contextul activ, offload, batching și decodarea speculativă.
| Cauză | Ce trebuie verificat |
|---|---|
| Offload CPU sau RAM | Plasarea straturilor încărcate și locația cache-ului |
| Context lung | Tokenurile ocupate în timpul măsurării |
| Diferențe de backend | Commit-ul runtime, driverul și calea kernelului |
| Decodare speculativă | Schițele acceptate și alocările suplimentare |
Pentru un model dens care generează câte un token, lățimea de bandă împărțită la numărul de octeți ai greutăților rezidente oferă o estimare aproximativă bazată doar pe lățime de bandă. La 448 GB/s și 11,8 GB de greutăți, câtul este de aproximativ 38 de tokenuri pe secundă. Citirile cache și calculele adaugă lucru, iar decodarea speculativă și batching-ul schimbă presupunerile.
Nu trata acest cât ca pe o limită superioară universală. O rată de ieșire mai mare nu invalidează automat un benchmark. Verifică dacă o trecere a modelului țintă a acceptat mai multe tokenuri schiță.
Predicția mai multor tokenuri, sau MTP, are nevoie de un model și un runtime compatibile. Compară rulările activate și dezactivate la contexte ocupate scurte și lungi. Greutățile suplimentare și starea schiței consumă memorie, dar nicio regulă universală nu impune dezactivarea MTP după 32K tokenuri.
Măsoară primul răspuns
Prefill procesează promptul înainte de generare. Decode produce răspunsul. Un decode rapid ascunde un prim răspuns lent când sarcina începe cu un prompt mare, fără cache.
Împarte tokenurile promptului fără cache la debitul prefill măsurat pentru a estima timpul de procesare. Pentru un prompt nou de 30.000 de tokenuri, două rate ilustrative produc aceste așteptări:
| Rata promptului, exemplu | Timp de procesare calculat |
|---|---|
| 750 tokenuri/s | 40 de secunde |
| 150 tokenuri/s | 200 de secunde |
Exemplele descriu timpul de procesare fără încărcarea modelului și overhead-ul cererii. Lungimea promptului, dimensiunea lotului, formatul modelului și backend-ul influențează rata măsurată.
Măsoară separat o cerere rece și o continuare cu prefix reutilizabil. Reutilizarea prefixului evită procesarea unei părți din intrarea repetată. Notează timpul până la primul token, rata decode și durata totală a sarcinii.
Compară sisteme GPU complete
Compară împreună prețul de cumpărare, memoria utilă, lățimea de bandă și calea software. O placă mai ieftină își pierde avantajul dacă volumul de lucru cere funcții fără suport sau depășește ținta de latență.
| Placă desktop de 16 GB | Lățime de bandă memorie |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Specificațiile AMD RX 9070 și RX 9070 XT confirmă capacitatea de 16 GB și lățimea de bandă de până la 640 GB/s. Comparația 640 cu 448 produce aproximativ 43% mai multă lățime de bandă teoretică. Din aceste specificații nu rezultă o îmbunătățire de 43% a inferenței.
Alege benchmark-uri care folosesc modelul și backend-ul dorite. Pentru prompturi scurte și generare susținută, acordă mai multă greutate performanței decode. Pentru analiza depozitelor, prioritizează prefill rece, viteza cu context lung și finalizarea cu succes a sarcinii. Verifică software-ul disponibil înainte de a cumpăra oricare furnizor.
Mac-uri și etichete de laptop
Un Mac Apple silicon de 16 GB împarte memoria între CPU, GPU, sistemul de operare și aplicații. Un GPU discret de 16 GB are memorie video dedicată pe lângă RAM-ul sistemului. Aceste capacități nu descriu bugete echivalente pentru modele.
Apple oferă o dimensiune recomandată pentru setul de lucru GPU . Verifică limita raportată de runtime și presiunea asupra memoriei sistemului. Lasă loc pentru macOS și celelalte aplicații, în loc să bugetezi întregul pool partajat pentru inferență.
Pentru laptopuri, verifică SKU-ul exact, memoria dedicată, limita de putere a GPU-ului și răcirea. Pagina familiei RTX 5060 de la NVIDIA listează variantele de memorie RTX 5060 Ti pentru desktop. Numele familiei nu confirmă singur 16 GB, iar rezultatele desktop nu confirmă debitul laptopului.
Se amortizează deținerea?
Deținerea se amortizează financiar când taxele de găzduire evitate depășesc costurile de operare și recuperează achiziția hardware. Începe cu un exemplu doar pentru ieșire: o placă de 789 USD, 35 de tokenuri de ieșire/s, 180 W în timpul generării, electricitate la 0,18 USD/kWh și 2,95 USD pentru un milion de tokenuri de ieșire găzduite. Acestea sunt valori ilustrative. Înlocuiește-le cu oferta ta, puterea măsurată, tariful electric și prețul furnizorului.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
La opt ore de generare neîntreruptă pe zi, același calcul durează aproximativ 291 de zile. Opt ore cu un asistent deschis diferă de opt ore de generare a tokenurilor.
La un preț găzduit de 0,16 USD per milion, electricitatea locală din acest scenariu costă deja mai mult decât găzduirea. În aceste condiții nu există un prag pozitiv de amortizare doar pentru ieșire.
Folosește prețurile actuale ale modelelor OpenRouter ale furnizorului selectat, inclusiv costurile pentru intrare și intrare cache-uită. Măsoară energia întregului sistem, inclusiv prefill. Adaugă upgrade-uri, energia în repaus, întreținerea și valoarea estimată la revânzare. Compară munca acceptată, deoarece reîncercările și diferențele de calitate schimbă costul pe sarcină.
Când să adaugi memorie
Depășește 16 GB când volumul de lucru măsurat depășește contextul disponibil la o calitate și latență acceptabile. Sesiunile lungi zilnice cu agenți, cererile concurente sau greutățile cu precizie mai mare fac utilă o capacitate mai mare.
Două plăci de 16 GB cer suport explicit din partea runtime-ului. Ele nu devin o alocare transparentă de 32 GB. Fiecare dispozitiv are nevoie de buffere, iar comunicarea folosește interconectarea gazdei.
| Strategie de împărțire | Principalul compromis |
|---|---|
| Împărțire pe straturi | Straturi diferite ocupă dispozitive diferite |
| Împărțire pe tensor sau rând | Lucrul din interiorul straturilor adaugă comunicare |
| CPU plus GPU | Mai multă capacitate cu alt profil de latență |
A doua placă merită luată în calcul când placa de bază, sursa, răcirea și backend-ul suportă deja planul. Compară costul complet al sistemului cu un GPU unic mai mare. Ghidul hardware Qwen de 32 GB acoperă aceste alternative.
Depanare și pașii următori
Dacă încărcarea eșuează, redu contextul și verifică alocările. Dacă viteza scade în timpul sesiunii, verifică contextul ocupat și offload-ul CPU. Dacă primul răspuns întârzie, măsoară prefill-ul rece. Dacă folosirea instrumentelor se strică după comprimare, compară aceeași sarcină cu un model cu precizie mai mare.
Salvează un test repetabil cu instrucțiunile, fișierele și rezultatele instrumentelor obișnuite. Notează revizia modelului, versiunea runtime, precizia cache-ului, contextul ocupat, memoria maximă, latența primului token, viteza decode și dacă sarcina a trecut. Repetă aproape de cea mai lungă sesiune așteptată.
Folosește ghidul pentru modele locale și context pentru a compara alternative mai mici. Alege cel mai mic model care îndeplinește cerințele de calitate, apoi rezervă suficientă memorie pentru sarcina completă. În aceste condiții, 16 GB reprezintă o țintă utilă pentru o stație de lucru.
Related Posts