Rutarea furnizorilor OpenRouter: calitatea modelului, limitele tokenurilor și costurile reale
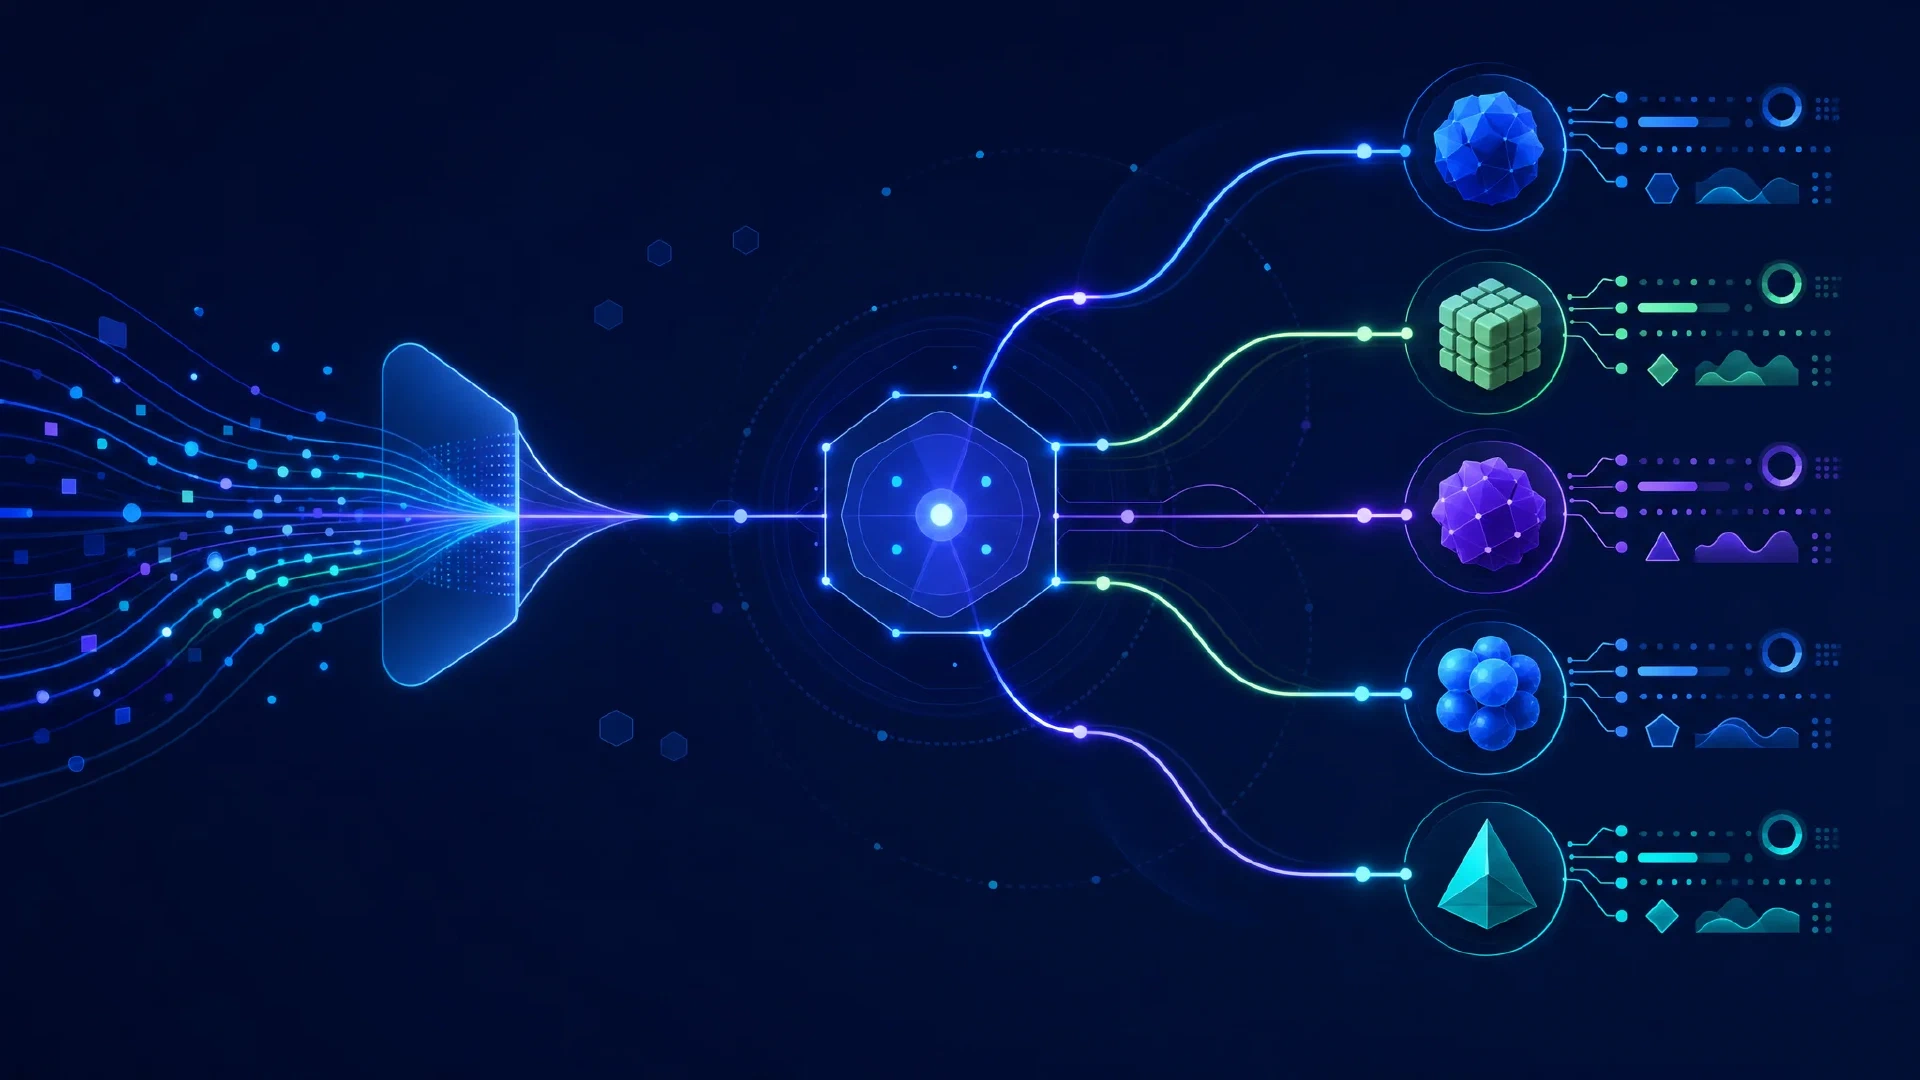
Table of Contents
Rutarea furnizorilor OpenRouter stabilește serviciul de inferență care răspunde cererii tale. Două apeluri cu același nume de model depind în continuare de limitele endpointului, parametrii acceptați, software-ul de servire și preferințele de rutare. Când răspunsurile devin mai scurte sau apelurile de instrumente eșuează, verifică aceste diferențe înainte să dai vina pe cuantizare.
Idei principale
- Etichetele de precizie descriu un format numeric, nu un scor de acuratețe.
- Limitele endpointului stabilesc contextul disponibil, lungimea ieșirii și suportul funcțiilor.
- Rutarea explicită are nevoie de o politică de fallback și de o preferință pentru furnizor.
- Auto Exacto îmbunătățește selecția furnizorului folosind semnale de calitate, cu o rută opt-in pentru cereri fără instrumente.
- Costul efectiv include ieșirea, comportamentul cache-ului, reîncercările și finalizarea cu succes a sarcinii.
Cerințe: Familiaritate cu cererile JSON și acces la configurația OpenRouter a aplicației tale. Inspecția endpointului folosește un API public. Trimiterea cererilor către model necesită o cheie API și generează costuri. Verifică din nou metadatele endpointului înainte să repeți un exemplu datat.
Timp și dificultate: Aproximativ 20 de minute pentru o primă verificare a configurației. Nivel intermediar. O comparație utilă între furnizori cere teste suplimentare cu prompturi reprezentative.
Ce omite numele modelului
Un identificator de model selectează modelul cerut. Furnizorul rulează serviciul de inferență, inclusiv implementarea modelului, limitele tokenurilor și parserul apelurilor de instrumente. Un benchmark la nivelul modelului nu validează fiecare serviciu care găzduiește acele ponderi.
| Proprietatea endpointului | Ce trebuie verificat |
|---|---|
| Lungimea contextului | Spațiu pentru prompt, istoric, rezultate de instrumente și generare |
| Lungimea maximă a completării | Alocația de ieșire pentru sarcina cerută |
| Parametrii acceptați | Utilizarea instrumentelor, ieșirea structurată, eșantionarea și controalele de raționament |
| Cuantizarea | Formatul raportat comparat cu versiunea originală |
| Prețul | Intrarea, ieșirea, citirile din cache și costurile suplimentare aplicabile |
| Comportamentul serviciului | Calitatea completării, erori de parsare, latență și reîncercări |
Rutarea de bază favorizează prețurile mici între candidații sănătoși. OpenRouter documentează ponderarea prin inversul pătratului prețului. În exemplul simplificat, un candidat de 1 USD primește o pondere de selecție de nouă ori mai mare decât unul de 3 USD. Acestea sunt ponderi relative, nu o garanție pentru următoarea cerere. Ordinea explicită, sortarea, cache-ul și rutarea după calitate influențează de asemenea selecția. Consultă documentația rutării furnizorilor .
Ponderarea după preț nu stabilește cea mai mică factură pentru volumul tău de lucru. Exemplul documentat nu definește o proporție universală intrare-ieșire pentru scalarul de preț. Nu deduce probabilitatea de selecție a furnizorului numai din prețul de intrare.
Citește precizia în context
Cuantizarea stochează valorile numerice într-o reprezentare redusă. Efectul depinde de model, metodă și implementarea inferenței. Precizia mai mică justifică testarea, dar eticheta singură nu dovedește că furnizorul a schimbat ponderile originale.
GPT-OSS oferă un exemplu concret. Documentația lansării OpenAI pentru gpt-oss-120b spune că ponderile experților mixture-of-experts folosesc MXFP4, iar evaluările au folosit aceeași cuantizare. Eticheta de patru biți este compatibilă cu versiunea publicată. Nu dovedește o degradare suplimentară făcută de furnizor.
Upcastingul convertește valorile stocate într-o reprezentare mai largă. Conversia unui checkpoint deja cuantizat la BF16 nu recuperează informațiile eliminate prin cuantizare. Conversia unui checkpoint inițial cu precizie mai mare la patru biți introduce, în schimb, o schimbare separată care merită evaluată.
| Observație | Concluzie susținută |
|---|---|
| Checkpoint MXFP4 nativ | Ponderile experților pe patru biți aparțin versiunii |
| Etichetă endpoint BF16 | Format raportat mai larg, fără dovada unor răspunsuri mai bune |
| Precizie necunoscută | Metadate lipsă, fără dovada degradării ascunse |
| Etichete de precizie identice | Dovezi insuficiente pentru un comportament echivalent |
Etichetele identice nu exclud diferențele de cuantizare. Ele omit detalii precum tensorii cuantizați, alegerile de calibrare și kernelurile de execuție. Testează endpointul complet, nu trata adâncimea în biți drept clasament al calității.
Verifică bugetul de tokenuri
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
API-ul endpointurilor expune metadate la nivel de furnizor pentru un model. Comanda are nevoie de curl și jq. Inspectează
răspunsul live al endpointului gpt-oss-120b
înainte să alegi un serviciu. Tratează câmpurile lipsă sau nule drept necunoscute, nu nelimitate. Salvează un snapshot local datat când compari rezultate.
O verificare din 5 octombrie 2026 a returnat limitele anunțate de mai jos pentru gpt-oss-120b. Sunt valori de metadate, nu lungimi măsurate ale completării. Furnizorii le schimbă în timp.
| Furnizor | Tokenuri de context | Număr maxim de tokenuri pentru completare |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
Lungimea contextului și lungimea ieșirii sunt limite separate. Un model cu context lung are tot nevoie de spațiu pentru răspuns. Istoricul conversației, instrucțiunile de sistem și definițiile instrumentelor consumă spațiu împreună cu documentul utilizatorului.
Tokenurile de raționament consumă și ele bugetul de generare la modelele care acceptă raționament. O alocație mică poate produce raționament incomplet, puțină ieșire vizibilă sau terminarea înaintea răspunsului final. Inspectează utilizarea și motivul terminării, nu presupune că orice răspuns scurt reflectă ponderi mai slabe. OpenRouter explică acest buget în documentația tokenurilor de raționament .
Un max_tokens explicit oferă routerului lungimea cerută a ieșirii pentru compararea cu suportul furnizorului. Alege-l din necesarul măsurat al sarcinii și contextul disponibil. O valoare excesivă restrânge eligibilitatea și nu garantează un răspuns mai lung sau mai bun.
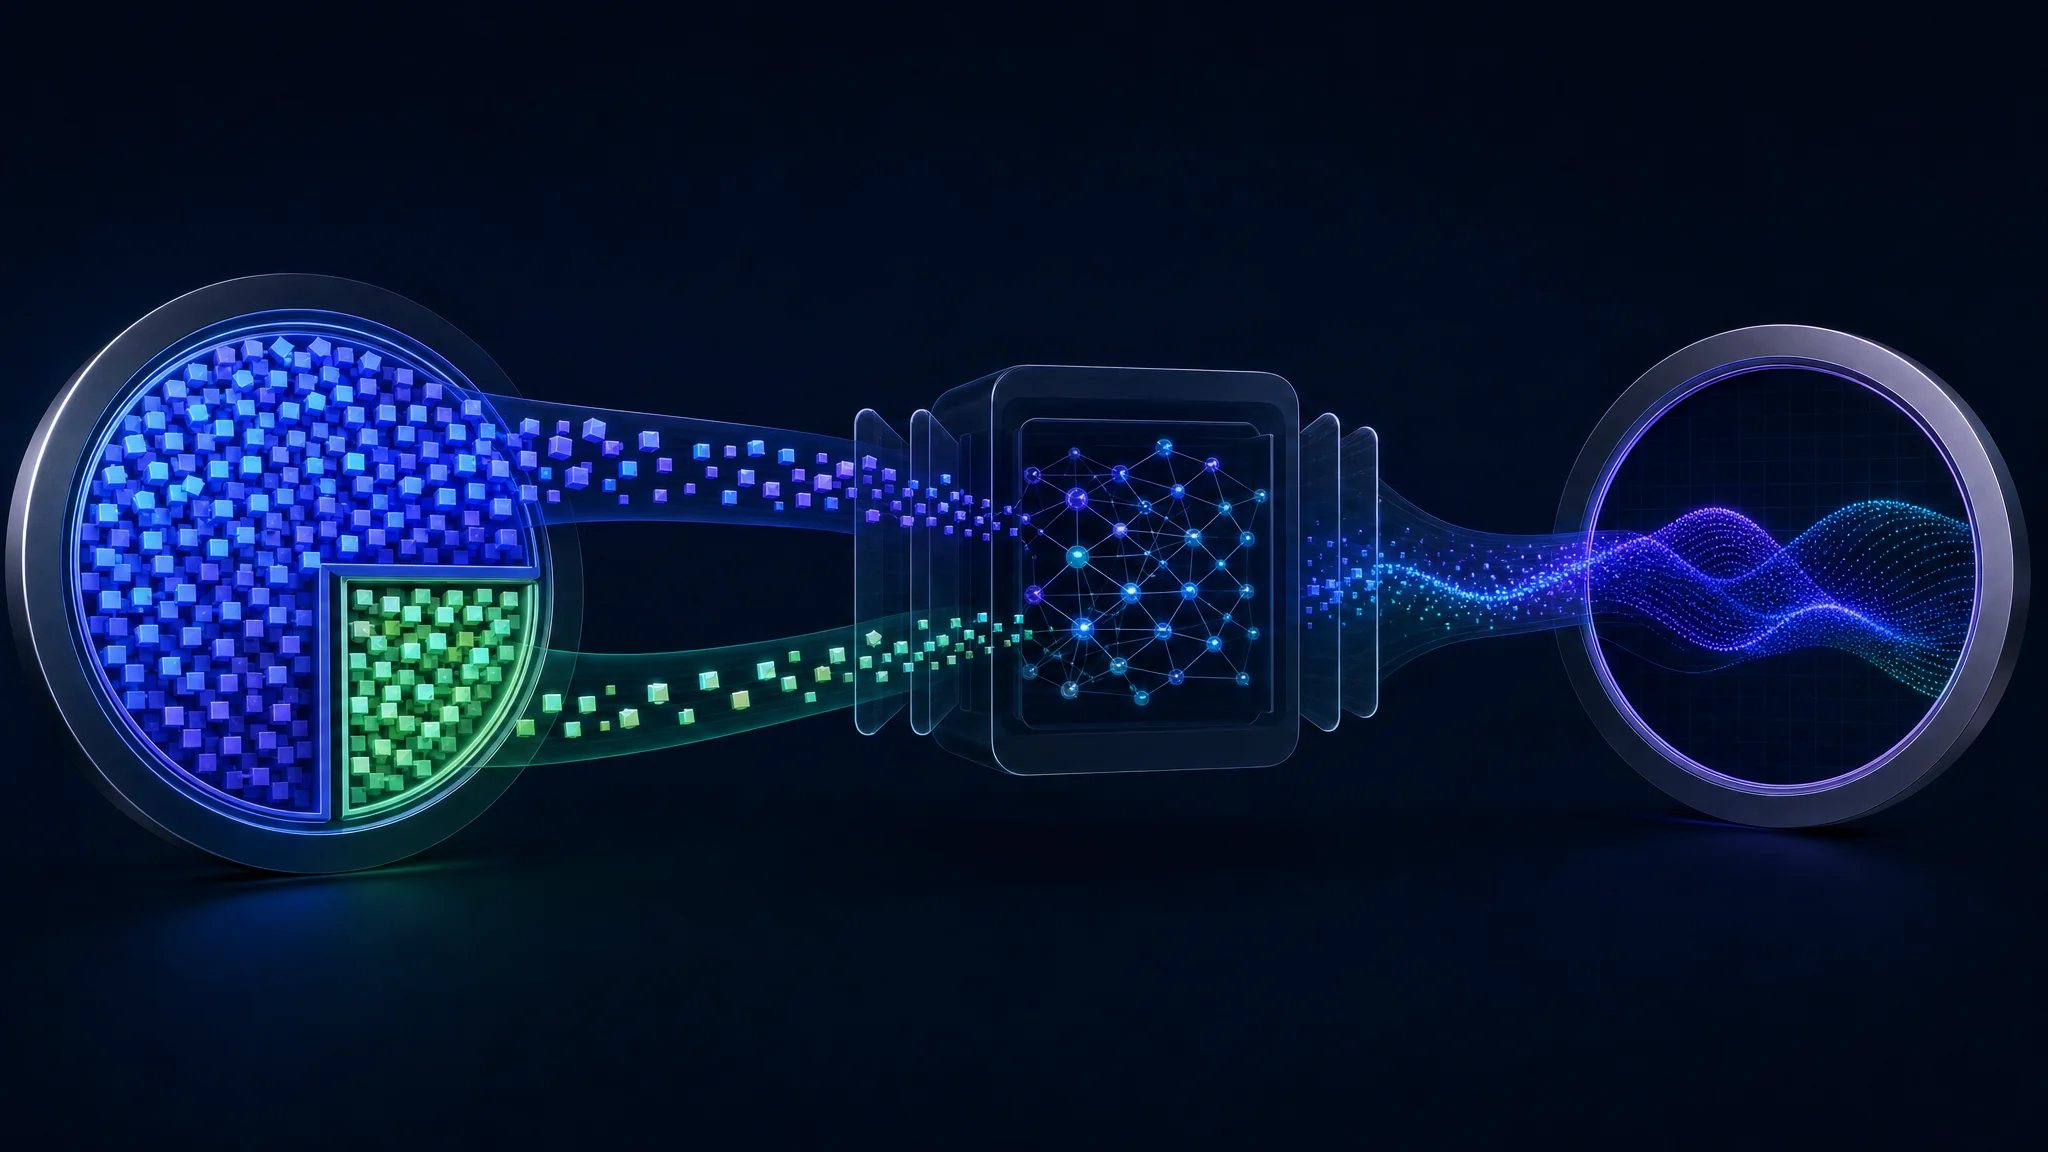
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Impune parametrii
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters are false implicit. În rutarea implicită, parametrii fără suport nu exclud neapărat un endpoint. OpenRouter documentează furnizori care ignoră parametrii necunoscuți. Valoarea true filtrează rutarea după suportul declarat.
Metadatele de suport nu garantează comportamentul. Un endpoint care declară suport pentru seed are încă nevoie de teste de reproductibilitate. Un endpoint capabil de instrumente are nevoie de validarea schemei și teste la nivelul aplicației. Filtrul împiedică incompatibilitățile cunoscute să intre în lista candidaților.
Fixează furnizorii intenționat
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Înlocuiește placeholderul cu slugul furnizorului copiat din lista de furnizori a modelului. Trimite raportul în cererea reală. Acest șablon este pentru verificarea configurației și nu devine executabil până nu înlocuiești placeholderul.
order stabilește preferința. Singur, lasă fallbackul către alți furnizori activ. Împreună cu allow_fallbacks: false, restrânge rutarea la furnizorii listați. Așteaptă un eșec când niciunul nu satisface cererea sau nu rămâne disponibil.
Variantele endpointului cer atenție. Un slug de bază se potrivește mai multor variante conform regulilor documentate. Folosește slugul variantei exacte când testezi o configurație specifică. Verifică furnizorul raportat pentru fiecare răspuns.
quantizations este o listă permisă de formate numite, nu un minim numeric. Un array cu "fp8" selectează endpointurile FP8 potrivite. Nu include automat BF16 sau toate formatele cu mai mulți biți. Compară întâi checkpointul original, apoi aplică filtrul numai când evaluarea susține restricția.
Păstrează activă rutarea după calitate
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto folosește debitul, telemetria apelurilor de instrumente și benchmarkurile pentru a retrograda furnizorii cu rezultate mai slabe. Anunțul OpenRouter din martie 2026 raportează o reducere de 88% a erorilor de apelare a instrumentelor pentru GLM-5, de la aproximativ 8% spre 1%. Raportează și gpt-oss-120b de la 5,6% la 3,5%.
Acestea sunt rezultate raportate de furnizor, nu o promisiune pentru aplicația ta. Validitatea apelului măsoară JSON, numele și schemele. Un apel valid sintactic are nevoie în continuare de argumentele și acțiunea corecte pentru sarcina utilizatorului.
Cererile cu instrumente primesc implicit Auto Exacto când modelul are acoperire suficientă din partea furnizorilor. Pentru celelalte cereri, :exacto activează rutarea după calitate. Documentația actuală susține rutarea de calitate pentru rezumare și chat, precum și pentru instrumente.
sort: "price", sufixul :floor și sortarea implicită după preț la nivelul contului dezactivează Auto Exacto. Verifică împreună setările aplicației și preferințele contului. Consultă
documentația Auto Exacto
înainte să combini controalele de rutare.
Calculează costul volumului de lucru
Prețul de intrare singur nu este o comparație completă. Ia aceste tarife ilustrative, exprimate în dolari pe milion de tokenuri. Ele arată calculul și nu sunt cotații actuale.
| Endpoint ilustrativ | Preț intrare | Preț ieșire |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
Endpointul A costă aproximativ de 4,2 ori mai mult pentru acest amestec, în ciuda prețului mai mic de intrare. Raportul 533 la 1 dintre prețurile de ieșire și intrare pentru A este un raport între două tarife, nu multiplicatorul costului total. Alte proporții intrare-ieșire schimbă comparația.
Unitățile de preț API diferă de tabelele comparative. API-ul endpointului exprimă prețurile pe token. Înmulțește cu un milion înainte să le compari cu tarifele de mai sus.
Cache-ul promptului introduce o variabilă nouă. Citirile din cache, scrierile în cache și intrarea fără cache cer o contabilitate separată după regulile furnizorului. Textul repetat nu garantează o potrivire în cache. Verifică numărul tokenurilor din cache și costurile raportate în documentația cache-ului pentru prompturi .
Rutarea afectează continuitatea cache-ului. OpenRouter documentează rutarea persistentă pentru cache, iar ordinea manuală a furnizorilor are prioritate. Auto Exacto reordonează furnizorii și uneori întrerupe un cache cald. Compară economiile observate cu cache-ul, calitatea și costurile reîncercărilor înainte să schimbi politica.
Costul per rezultat acceptat este metrica utilă a aplicației. Împarte cheltuiala totală, inclusiv reîncercările și încercările eșuate, la rezultatele care îndeplinesc criteriile tale. Include separat eventualele costuri fără tokenuri. O rată mică per token nu compensează sarcinile eșuate repetat.
Diagnostichează un răspuns inconsistent
| Simptom | Prima verificare |
|---|---|
| Răspuns scurt sau neterminat | Motivul finalizării, limita ieșirii, folosirea raționamentului |
| Detalii lipsă din document | Conținutul trimis, limita de context, trunchierea clientului |
| Apel de instrument malformat | Suportul declarat, schema instrumentului, comportamentul parserului |
| Comportament diferit al eșantionării | Parametrii ceruți și suportul declarat |
| Cheltuială neașteptată | Volumul ieșirii, citirile cache, reîncercările, schimbările furnizorului |
| Niciun furnizor eligibil | Limite conflictuale, allowlisturi și restricții de fallback |
Păstrează ID-ul de generare returnat în răspuns. API-ul de metadate pentru generări OpenRouter expune identitatea furnizorului, utilizarea, costul și informațiile de finalizare. Un ID de sesiune grupează lucrări asociate, dar nu înlocuiește ID-ul generării pentru o singură cerere.
Salvează cererea lângă ID-ul generării. Păstrează modelul, preferințele furnizorului, parametrii, momentul și utilizarea răspunsului. Astfel, o comparație ulterioară de calitate sau cost rămâne reproductibilă când se schimbă rutarea, prețurile ori metadatele endpointului.
Compară endpointurile în condiții egale. Folosește același prompt, aceleași instrumente, setări de raționament și buget de tokenuri. Repetă testul pentru mai multe sarcini reprezentative. Separă răspunsurile incomplete, apelurile invalide și răspunsurile greșite, nu le combina într-un scor de calitate fără explicație.
Incertitudinea benchmarkului contează. Analiza Epoch AI despre de ce benchmarkingul este dificil descrie variații produse de implementări, eșantionare și structuri de agenți. Un răspuns dezamăgitor nu dovedește un defect persistent al furnizorului sau cauza lui.
Ghid de rutare a endpointului
Vizionare suplimentară: Discuție despre calitatea și rutarea endpointurilor OpenRouter . Verifică din nou listele de endpointuri înainte să aplici prețuri, limite sau comparații specifice.
Pașii următori
- Inspectează endpointurile unui model și notează limitele relevante pentru volumul tău.
- Alege o politică de rutare cu cerințe explicite pentru parametri și fallback.
- Testează sarcini reprezentative cu endpointuri candidate și rutarea după calitate.
- Notează costul rezultatului acceptat împreună cu latența, utilizarea cache-ului și categoriile de eșec.
- Verifică din nou după schimbări ale versiunilor modelului, comportamentului serviciului sau prețurilor furnizorului.
Pentru fundamente AI mai largi, continuă cu Concepte de bază despre AI . Pentru permisiunile agenților și controalele de validare, citește Securizarea sistemelor AI .
Related Posts