Programare locală cu AI pe un GPU de 16 GB: Strata, OpenCode și Qwen3.8
Table of Contents
Un agent local de programare pe un GPU de 16 GB este o opțiune practică pentru sarcini de dezvoltare delimitate. Strata și OpenCode combină inferența locală cu editarea fișierelor, comenzile shell și rularea testelor. O rulare raportată Qwen3.8-Flash-Next pe un RTX 4060 Ti a finalizat o aplicație, modificări ulterioare și un prototip de joc de curse fără apeluri de inferență plătite.
Înlocuirea unui abonament cere un test mai amplu. Rezultatele publicate demonstrează o configurație funcțională pe un singur calculator. Ele nu stabilesc paritatea cu serviciile plătite de programare pentru limbaje, depozite sau sarcini dificile de depanare diferite. Hardware-ul include și 64 GB de RAM de sistem, care păstrează o mare parte din model.
Idei principale
- 16 GB descrie memoria GPU, nu memoria totală necesară configurației raportate.
- Reutilizarea promptului contează, deoarece agenții de programare trimit repetat istoricul suprapus al conversației.
- Raționamentul are nevoie de un buget, pentru ca planificarea să lase loc pentru cod și apeluri de instrumente.
- Trecerea testelor generate este o dovadă parțială, iar Docker și jocul cer verificări separate.
- Cheltuielile API zero exclud costurile de deținere, energia electrică și timpul de mentenanță.
Cerințe: Un calculator compatibil, spațiu liber suficient pentru modelul ales, Git, Node.js cu npm și familiaritate cu instrumentele de terminal. Reproduce configurația IQ3_S raportată cu 64 GB RAM. Folosește instalatorul Strata actual pentru a verifica alte configurații.
Timp și dificultate: Intermediar. Alocă timp pentru descărcarea modelelor mari și instalare înainte de evaluarea vitezei de finalizare a sarcinilor. Duratele raportate exclud instalarea.
Configurația testată
| Componentă | Configurație raportată |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB VRAM |
| CPU | Intel Core i5-11600K |
| Memorie de sistem | 64 GB RAM |
| Stocare | SSD NVMe |
| Model | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Motor de inferență | Strata |
| Agent de programare | OpenCode |
| Context configurat | 65.536 tokeni |
| Limită de ieșire configurată | 16.384 tokeni |
Configurația și rezultatele publicate de NetworkCoder furnizează aceste valori. Depozitul de test raportează încărcarea a 46,84 GiB de greutăți ale experților în 28 de secunde, cu 4.431 de experți ocupând 8,45 GiB de memorie GPU. Aceste măsurători descriu rularea testată, nu o alocare garantată pe altă versiune a motorului.
Compatibilitatea actuală este mai largă decât acest test. Conform verificării din 6 octombrie 2026, proiectul Strata documentează anumite plăci NVIDIA și AMD cu cel puțin 12 GB VRAM, plus modele mai mici pentru sisteme cu 32 GB RAM. Aceste opțiuni nu reproduc experimentul cu GPU de 16 GB, RAM de 64 GB și IQ3_S. Verifică GPU-ul exact, varianta modelului și suportul runtime-ului înainte de cumpărarea hardware-ului.
Unde se află modelul
Mixture of experts, sau MoE, activează un subset al rețelelor de experți ale modelului pentru fiecare token. Acest lucru reduce calculul activ față de folosirea fiecărui parametru la fiecare pas. Greutățile rămase au în continuare nevoie de stocare și de o cale către calcul.
Execuția hibridă a Strata păstrează experții utilizați frecvent pe GPU și colecția de experți în RAM-ul sistemului. CPU calculează experții fără cache local, iar GPU gestionează experții din cache. Stocarea păstrează și fișierele modelului și datele de căutare. Sistemul nu înghesuie întregul model 125B în 16 GB VRAM.
Memoria GPU are utilizări concurente. Alocările runtime-ului, starea atenției și cache-ul de experți împart o resursă limitată. Mai mult spațiu pentru context schimbă capacitatea rămasă pentru cache-ul de experți. Versiunile actuale ale Strata acceptă și streaming pentru cache-ul KV, astfel că amplasarea exactă diferă de o configurație mai veche. Consultă documentația tehnică pentru versiunea motorului tău.
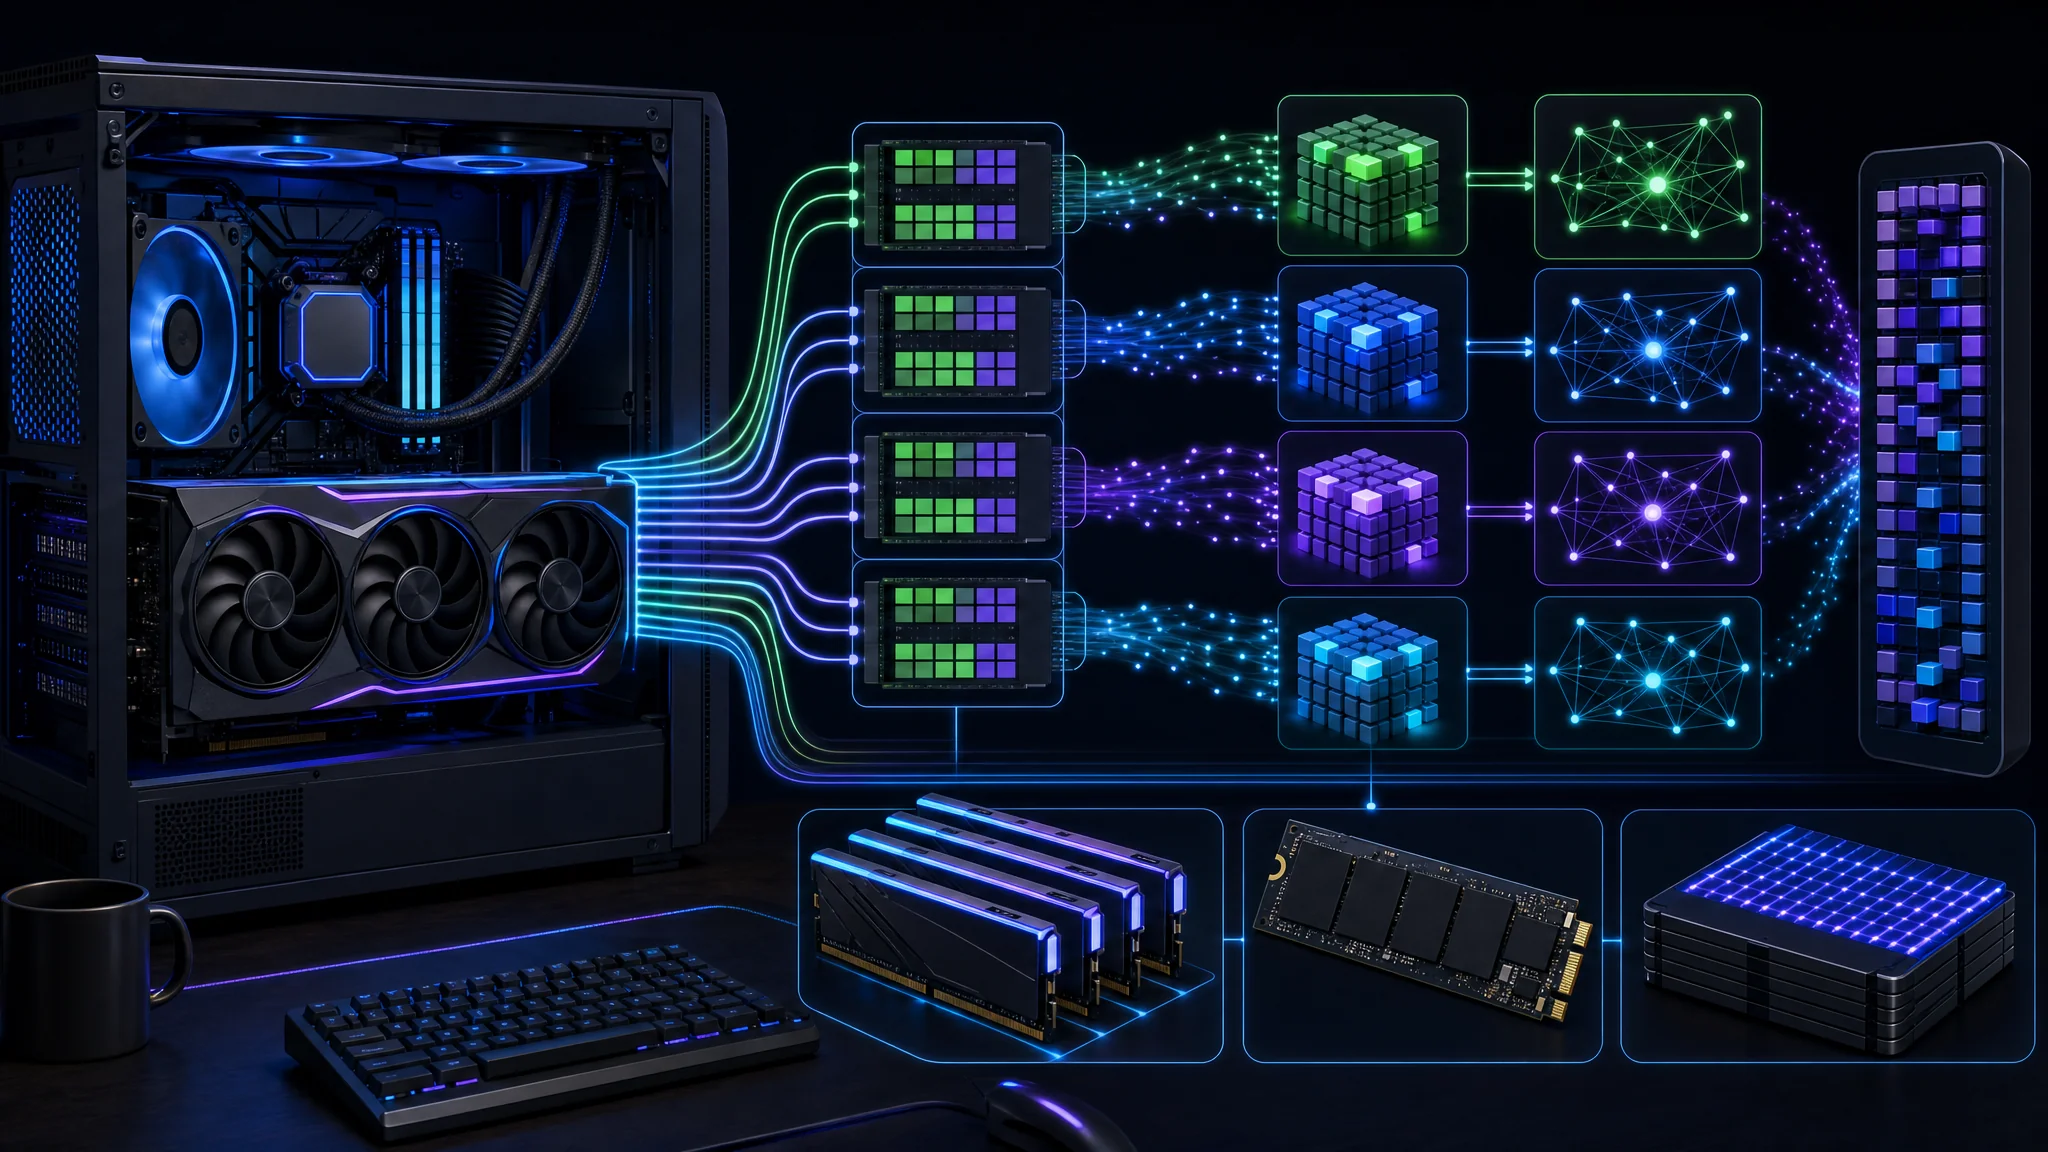
GPU-ul este o parte a sistemului de inferență, alături de execuția CPU, RAM-ul sistemului și stocare
Reutilizarea promptului schimbă viteza
Un agent de programare rulează într-o buclă: citește sarcina, solicită o acțiune a unui instrument, primește rezultatul și decide acțiunea următoare. Conținutul fișierelor, erorile și rezultatele testelor se acumulează în conversație. Agenții compactează sau selectează și contextul, astfel că nu fiecare implementare retrimite la nesfârșit un istoric complet neschimbat.
Prefill procesează tokenii de intrare înainte de generare. Decode produce răspunsul. Un sistem cu decode rapid, dar cu prefill repetat lent, te lasă să aștepți între apelurile instrumentelor.
Măsurarea raportată pentru 44K de tokeni a folosit reutilizarea prefixului. Strata a reutilizat conținutul conversației procesat anterior, iar promptul în creștere era gata în aproximativ una până la trei secunde. Aceasta este o dovadă utilă pentru o sesiune continuă a agentului. Nu dovedește procesarea a 44.000 de tokeni complet noi de la zero într-o secundă.
| Măsurare | Ce trebuie înregistrat |
|---|---|
| Prompt rece | Timpul pentru conținut nou fără stare de prefix reutilizabilă |
| Continuare caldă | Timpul după adăugarea rezultatului unui instrument la contextul existent |
| Viteza de generare | Tokeni pe secundă în timpul răspunsului |
| Durata sarcinii | Planificare, generare, instrumente, teste și reîncercări împreună |
Cele două cache-uri au scopuri diferite. Cache-ul de experți ține greutățile utilizate frecvent aproape de calculul GPU. Reutilizarea prefixului evită repetarea lucrului pentru intrările anterioare. O rată mare de accesări reușite în cache-ul de experți nu dovedește o accesare reușită în cache-ul promptului.
Ce au demonstrat sarcinile
| Sarcină | Timp raportat | Rezultat raportat |
|---|---|---|
| Construire manager de sarcini | 3 min 38 s | API Express, interfață, teste 5/5 |
| Reparare editare și adăugare date | 4 min 58 s | Modificări finalizate, teste 6/6 |
| Adăugare export, import și împachetare | 3 min 48 s | Teste 7/7, build Docker neverificat |
| Joc de curse, prima încercare | 6 min 35 s | Ieșirea epuizată în timpul raționamentului, fără cod |
| Joc de curse, reîncercare cu buget | 4 min 51 s | Joc generat, sintaxă JavaScript verificată |
Fișierul de rezultate publicat înregistrează viteze de ieșire de 48–52 tokeni pe secundă pentru prima sarcină, 40–43 pentru a doua și 37–44 pentru a treia. „Până la 52” este un vârf în cadrul acestor observații, nu o rată susținută pentru fiecare sarcină.
Primele trei sarcini extind aceeași aplicație. Valorile 5/5, 6/6 și 7/7 descriu suite de teste succesive. Adunarea lor nu stabilește 18 capabilități independente. Testele scrise de același agent cer și ele verificarea acoperirii și a aserțiunilor utile.
Recuperarea mediului a făcut parte din lucru. Agentul s-a recuperat după o comandă shell nepotrivită și a identificat un server de aplicație vechi în timpul testării. Sunt comportamente utile, dar terminarea unui proces existent cere permisiuni deliberate într-un mediu de dezvoltare partajat.
Docker a rămas neverificat. Agentul a scris un Dockerfile, dar nu avea un motor Docker pornit pentru build. Testele aplicației trecute în afara containerului nu stabilesc existența unei imagini funcționale. Reîncercarea jocului a verificat și sintaxa și a deschis un browser, însă agentul nu a avut confirmare vizuală directă a jocului.
Rezervă spațiu pentru ieșire
{
  "reasoning_budget_tokens": 8000
}
Îmbină această setare cu configurația existentă strata-iq3_s.json, păstrând celelalte câmpuri, apoi repornește modelul Strata ales. Este o setare Strata, nu un fișier de configurare OpenCode de înlocuire. Verifică bugetul activ în ieșirea de pornire.
Strata documentează un buget strict pentru raționament care încheie faza de gândire și trece spre răspuns. O valoare la nivelul cererii înlocuiește valoarea implicită configurată. Setarea diferă de o instrucțiune generală privind efortul de raționament, precum scăzut sau ridicat.
Prima încercare a jocului și-a consumat limita de 16.384 de tokeni în timpul planificării. Reîncercarea a aplicat un buget de gândire de 8.000 de tokeni și a livrat cod. Acest lucru susține utilizarea unei faze de raționament delimitate pentru această sarcină. Nu stabilește că 8.000 este setarea optimă pentru fiecare sarcină.
Limita de ieșire rămasă este un maximum, nu o rezervă garantată. Dacă un plafon de 8.000 de tokeni s-ar consuma complet sub o limită totală de 16.384, ar rămâne aproximativ 8.384 de tokeni înaintea altor costuri. Jurnalul rezultatelor raportează 11.054 de tokeni scriși la reîncercare, fără o separare completă între raționament și cod. Nu interpreta acest lucru ca 8.000 de tokeni de raționament plus 11.054 de tokeni de cod sub aceeași limită.
Folosește un buget mai mic pentru editări restrânse, apoi testează bugete mai mari pentru sarcini care cer mai multă analiză. Inspectează ieșirea completă a fișierului, starea finalizării și rezultatele testelor. Mai mult timp de planificare ajută doar dacă îmbunătățește modificarea livrată.
Conectează Strata și OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Acesta este punctul de intrare pentru instalarea Linux. Consultă instrucțiunile actuale de instalare și folosește START-HERE.bat pentru calea Windows documentată. Selectează varianta originală Qwen3.8-Flash-Next IQ3_S și un context de 65.536 de tokeni pentru a aproxima configurația raportată. Salvează versiunea motorului și fișierele modelului selectat în notițele benchmarkului.
npm install -g opencode-ai
Instalează OpenCode folosind
instrucțiunile oficiale
. Într-un terminal separat, definește STRATA_BASE_URL ca baza API locale afișată de Strata, inclusiv sufixul /v1. Păstrează inferența legată de calculatorul local pentru această configurație.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Îmbină blocul providerului în ~/.config/opencode/opencode.json, păstrând setările existente. Acesta adaptează
configurația exemplu publicată
încărcând endpointul local dintr-o variabilă de mediu. OpenCode documentează
providerii personalizați
și
înlocuirea variabilelor de mediu
.
local este o acreditare de înlocuire, conformă cu exemplul local fără autentificare. Nu securizează un server. Dacă instanța Strata activează autentificarea, furnizează acreditarea configurată prin mecanismul local potrivit pentru secrete.
Pornește opencode într-o copie eliminabilă a proiectului și selectează modelul configurat. Verifică providerul ales înainte de trimiterea codului. Declarația de context a clientului nu mărește contextul configurat pe server, iar o fereastră de 65.536 de tokeni nu lasă 65.536 de tokeni pentru intrare când este nevoie și de spațiu pentru ieșire.
Inferență locală și permisiuni
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Îmbină aceste permisiuni inițiale în configurația OpenCode în timpul evaluării agentului. Documentația permisiunilor explică mecanismele disponibile. Modificările fișierelor și execuția shell afectează calculatorul indiferent de locul în care rulează inferența.
Inferența locală nu face toate instrumentele locale. Descărcările de pachete, instrumentele web, integrările externe și partajarea opțională implică în continuare servicii de rețea. Verifică instrumentele activate înainte de lucrul cu depozite private. „Modelul rulează local” este o afirmație mai îngustă decât „nimic nu părăsește calculatorul”.
Depanarea primei rulări
| Simptom | Ce trebuie verificat întâi |
|---|---|
| Provider indisponibil | Strata rulează și variabila de mediu ajunge la procesul OpenCode |
| Model absent din selecție | ID-ul providerului și ID-ul modelului corespund configurației salvate |
| Eroare de limită a contextului | Lungimea promptului plus ieșirea cerută încap în fereastra activă a serverului |
| Planificare fără cod | Bugetul de raționament, limita totală de ieșire și starea finalizării |
| Continuare lentă | Reutilizarea prefixului, presiunea pe memorie, comportamentul cache-ului de experți și procese concurente |
| Comanda Docker eșuează | Este disponibil un motor funcțional, nu doar clientul său în linie de comandă |
Schimbă câte o setare pe rând și repetă aceeași sarcină pornind de la o stare inițială salvată. Astfel separi o îmbunătățire de configurare de un prompt diferit sau de un test mai ușor.
Înlocuiește un abonament?
| Merită testată configurația locală | Păstrează o altă opțiune |
|---|---|
| Hardware compatibil existent | Cumpărarea hardware-ului exclusiv pentru o sarcină netestată |
| Modificări limitate ale aplicației | Depozite mari, necunoscute și migrări dificile |
| Teste de acceptare repetabile | Sarcini fără metode sigure de verificare a corectitudinii |
| Timp pentru mentenanța runtime-ului | Muncă ce cere configurare și suport minime |
Cheltuielile API zero sunt relevante, mai ales când hardware-ul există deja. Ele exclud energia electrică, deprecierea hardware-ului, stocarea și timpul de întreținere a mediului. Câmpul afișat pentru cost zero nu măsoară nici aceste cheltuieli.
O comparație a abonamentelor cere sarcini identice. Rulează același depozit inițial, aceleași instrucțiuni și aceleași verificări de acceptare prin ambele sisteme. Înregistrează reîncercările și corecțiile umane împreună cu timpul scurs. Include prima încercare eșuată a jocului când evaluezi întregul flux, nu doar reîncercarea reușită.
Un agent local util nu trebuie să fie superior în toate situațiile. Dacă gestionează fiabil editările de rutină și lasă un set mic de sarcini dificile unui alt instrument, el schimbă deja serviciile plătite de care ai nevoie. Decide pe baza lucrului acceptat în proiectele tale.
Demonstrație și pașii următori
Vizionare suplimentară: Demonstrația agentului local de programare 125B . Măsurătorile de mai sus aparțin testului publicat, nu unui benchmark independent realizat pentru acest articol.
- Reproduce o sarcină mică cu criterii de acceptare fixe și o revizie inițială salvată.
- Măsoară turele reci și calde în loc să tratezi reutilizarea prefixului drept viteză de prefill rece.
- Verifică separat împachetarea printr-un build reușit al imaginii, pornire și verificări la nivel de container.
- Inspectează testele generate și adaugă cazuri pe care implementarea nu le-a anticipat.
- Compară lucrul finalizat cu instrumentul tău actual de programare înainte de schimbarea abonamentelor.
Pentru planificarea hardware-ului, citește ghidul pentru modele AI locale și contextul GPU . Pentru comportamentul modelelor găzduite, consultă rutarea și costurile providerilor OpenRouter .
Related Posts